AI 적용 사례 – Contextual Retrieval로 RAG 검색 실패 줄이기
Contextual Retrieval은 Anthropic이 2024년 9월 19일에 공개한 검색 개선 기법입니다. 문서를 조각내 검색하는 RAG에서 조각이 맥락을 잃는 문제를 다루는데, 방법은 조각마다 짧은 맥락 설명을 만들어 앞에 붙이는 것이에요.
RAG 글에서는 이 사례를 한 절로 짧게 소개했습니다. 이번에는 Anthropic의 원문을 따라 맥락을 어떻게 만들고 어디에 붙이는지, 수치는 어떤 조건에서 나왔는지를 순서대로 풀어 봅니다.
조각 하나만 보면 어느 회사 얘기인지 알 수 없다
RAG는 문서를 보통 수백 토큰을 넘지 않는 조각으로 나눠 두고 질문과 가까운 조각을 찾아 옵니다. 원문은 이 방식이 많은 경우에 잘 동작하지만, 조각 하나에 맥락이 충분히 담기지 않으면 문제가 생긴다고 짚어요.
원문이 드는 예는 미국 증권거래위원회(SEC) 공시 자료를 모아 둔 지식 베이스입니다. 여기에 어느 회사의 2023년 2분기 매출 성장률을 묻는 질문이 들어왔다고 해 보죠. 관련 조각에는 “회사의 매출이 전 분기보다 3% 늘었다”는 문장이 들어 있는데, 이 조각만 봐서는 어느 회사의 어느 기간 얘기인지 나와 있지 않습니다. 그러면 맞는 조각을 찾아 오기도, 찾아 온 조각을 제대로 쓰기도 어려워집니다.
Contextual Retrieval은 조각 앞에 맥락 설명을 붙인다
Contextual Retrieval이 하는 일은 이렇습니다. 그 조각에만 해당하는 설명을 조각 앞에 덧붙이고, 설명이 붙은 조각으로 임베딩을 만들고 BM25 색인도 만드는 거예요. 원문은 앞의 것을 Contextual Embeddings, 뒤의 것을 Contextual BM25라고 부르고, 이 둘을 Contextual Retrieval의 하위 기법으로 소개합니다.
앞의 예에 적용하면 조각 앞에 이런 내용이 붙습니다. 이 조각은 ACME Corp의 2023년 2분기 실적을 다룬 SEC 공시에서 나왔다는 것, 그리고 직전 분기의 매출이 얼마였는지입니다. 원래 문장은 그 뒤에 그대로 남아요.
원문에 실린 예시를 그대로 옮기면 아래와 같습니다.
original_chunk = "The company's revenue grew by 3% over the previous quarter."

contextualized_chunk = "This chunk is from an SEC filing on ACME corp's performance in Q2 2023; the previous quarter's revenue was $314 million. The company's revenue grew by 3% over the previous quarter."
원래 조각
- 매출이 전 분기보다 3% 늘었다는 문장만 있다
- 회사 이름과 기간이 조각에 없다
맥락을 붙인 조각
- 어느 회사의 어느 분기 공시인지가 앞에 붙는다
- 원래 문장은 뒤에 그대로 이어진다
맥락을 활용해 검색을 개선하려는 다른 제안들도 원문에 언급됩니다. 문서 전체의 일반적인 요약을 조각에 붙이는 방법은 실험해 보니 향상 폭이 매우 제한적이었고, 요약 기반 색인은 평가에서 성능이 낮았다고 해요. 원문은 이런 방법들이 이 글에서 제안하는 것과 다르다고 구분합니다.
RAG – 원리와 쓰지 않아도 되는 경우맥락은 모델이 조각마다 써 준다
Contextual Retrieval을 구현하는 방법도 원문에 나옵니다. 지식 베이스의 조각은 수천 개에서 수백만 개에 이를 수 있어서 사람이 하나하나 설명을 달기에는 일이 너무 많다고 원문은 말합니다. 그래서 이 작업을 Claude에게 맡겼고, 맥락을 만드는 데는 Claude 3 Haiku를 썼어요.
프롬프트의 구성은 이렇습니다. 문서 전체를 먼저 넣고, 그다음에 설명을 달 조각 하나를 넣습니다. 그리고 이 조각이 전체 문서에서 어떤 위치에 있는지를, 검색이 잘 되게 하려는 목적으로 짧고 간결하게 써 달라고 요청해요. 답에는 그 맥락만 쓰고 다른 말은 넣지 말라는 지시도 붙어 있습니다.
원문에 공개된 프롬프트는 이렇게 생겼습니다.
<document>
{{WHOLE_DOCUMENT}}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{{CHUNK_CONTENT}}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else.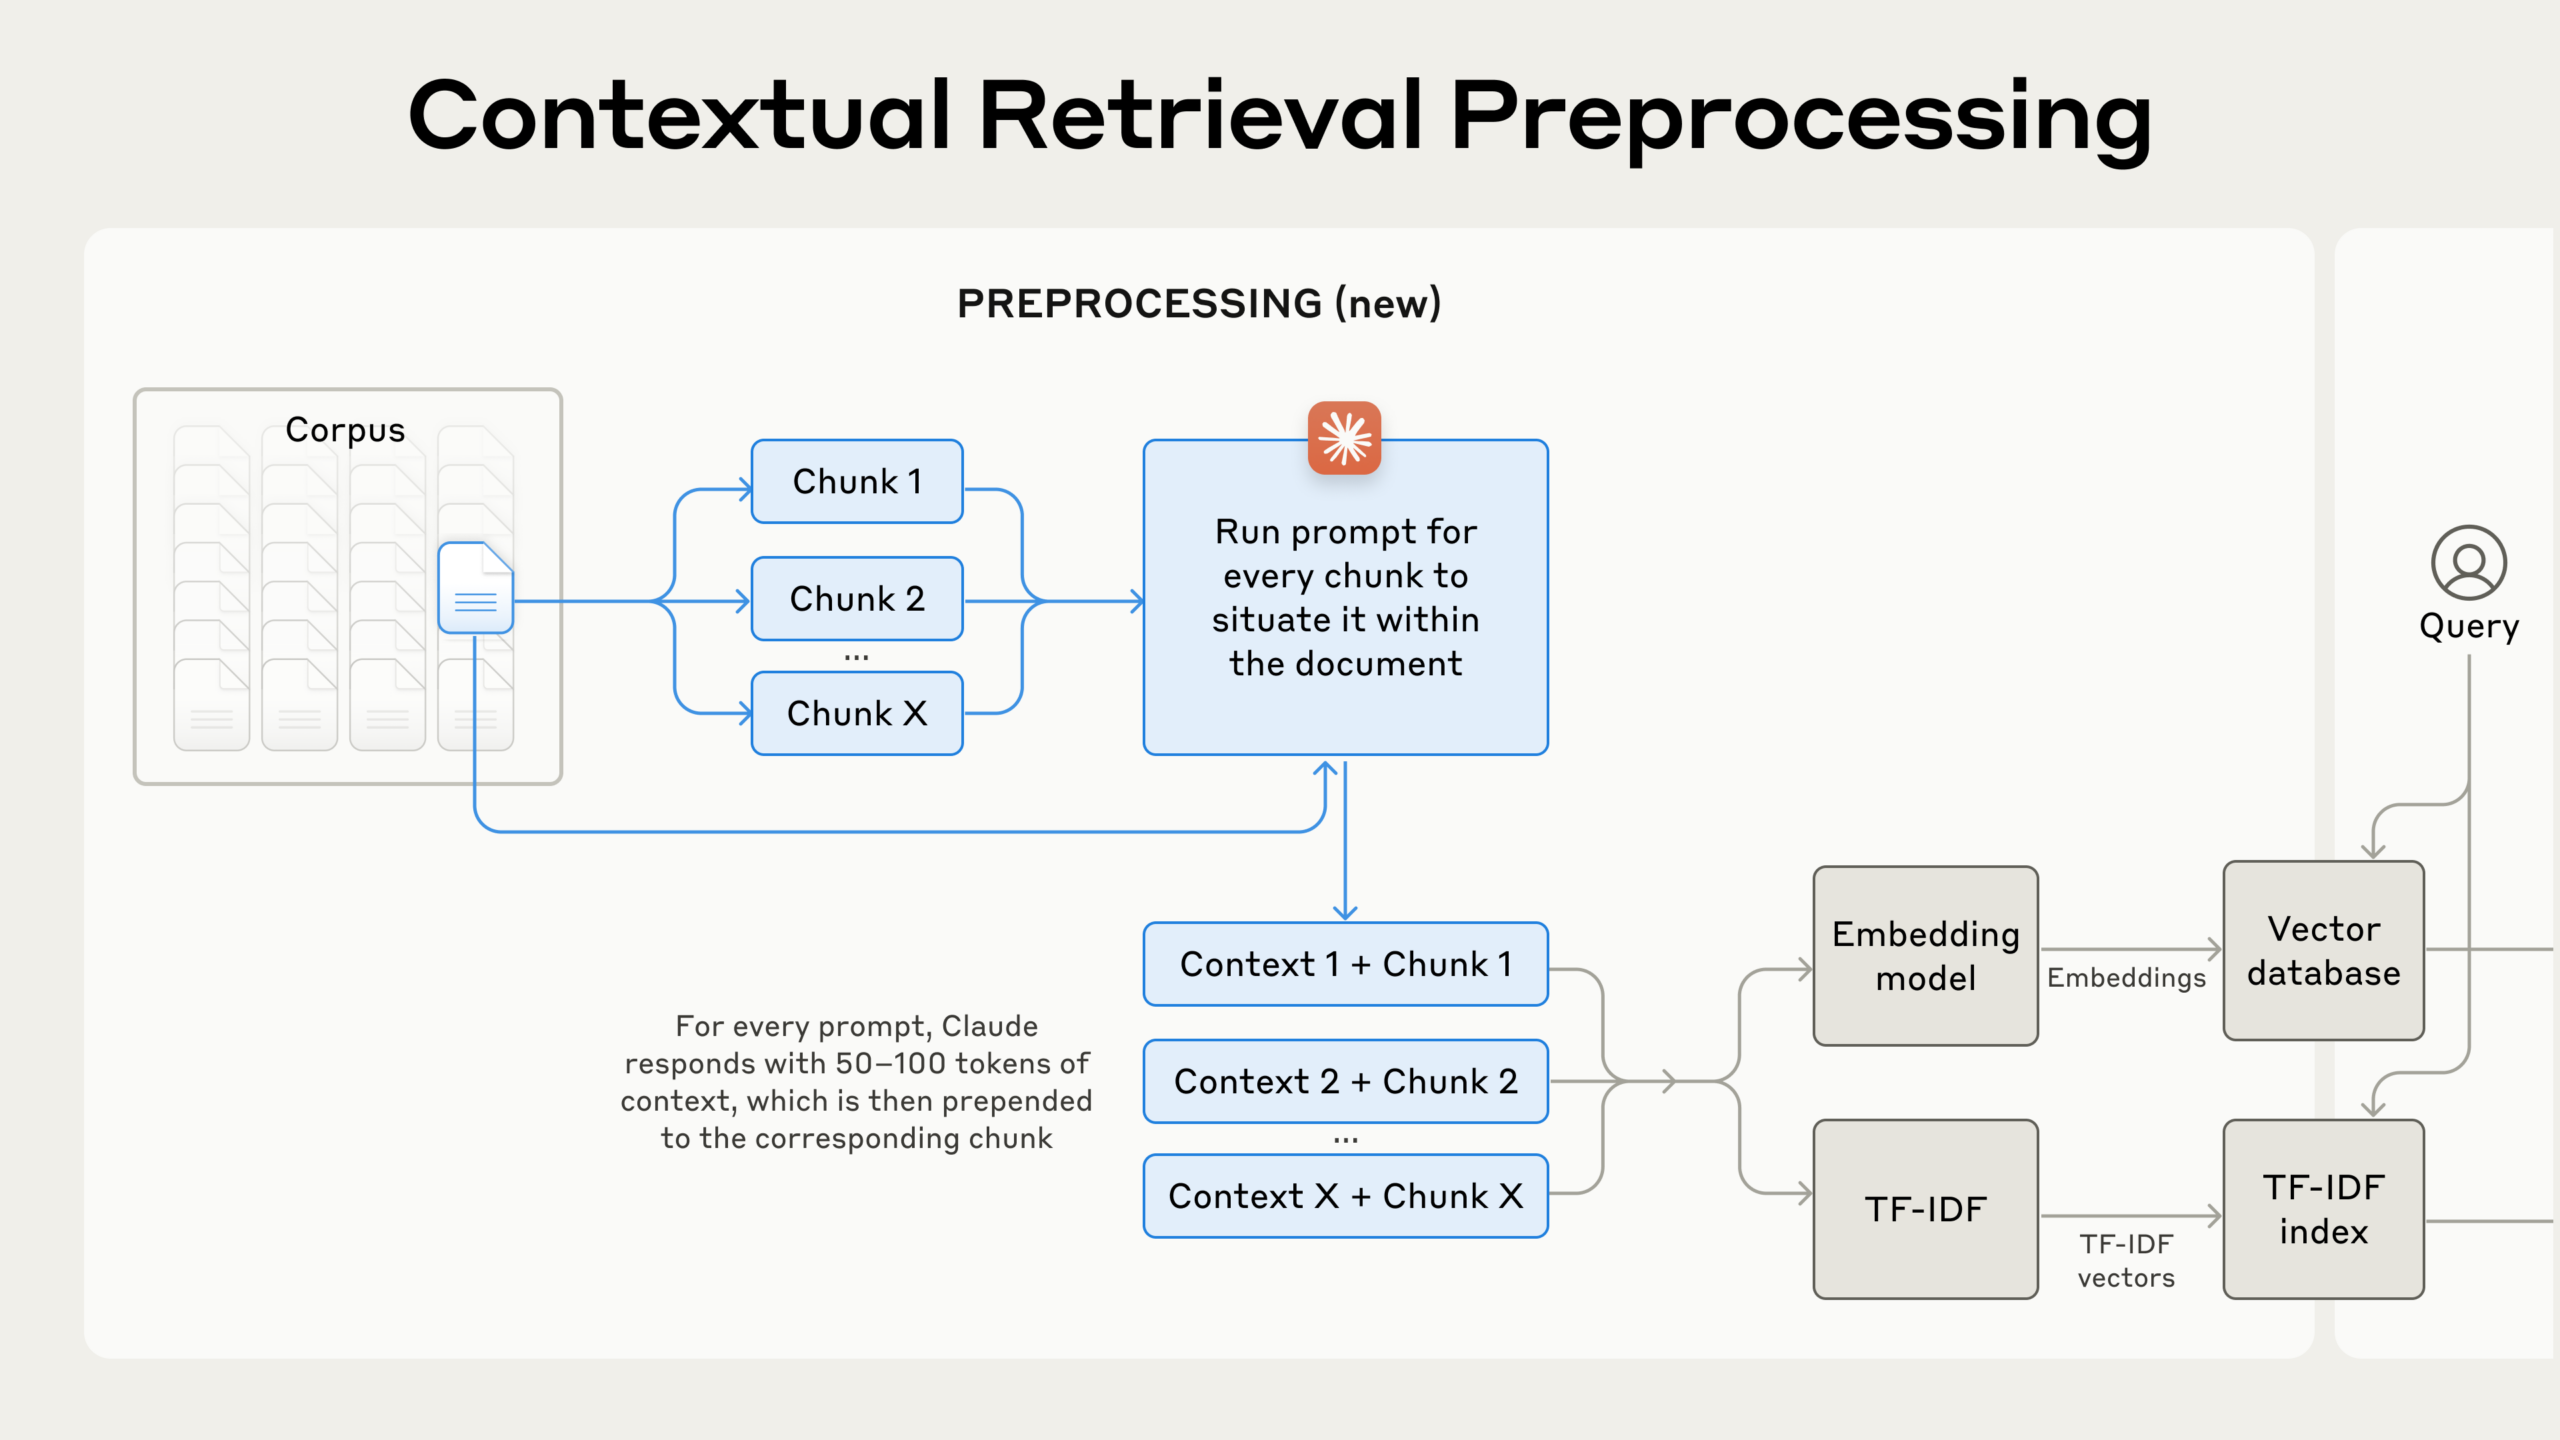
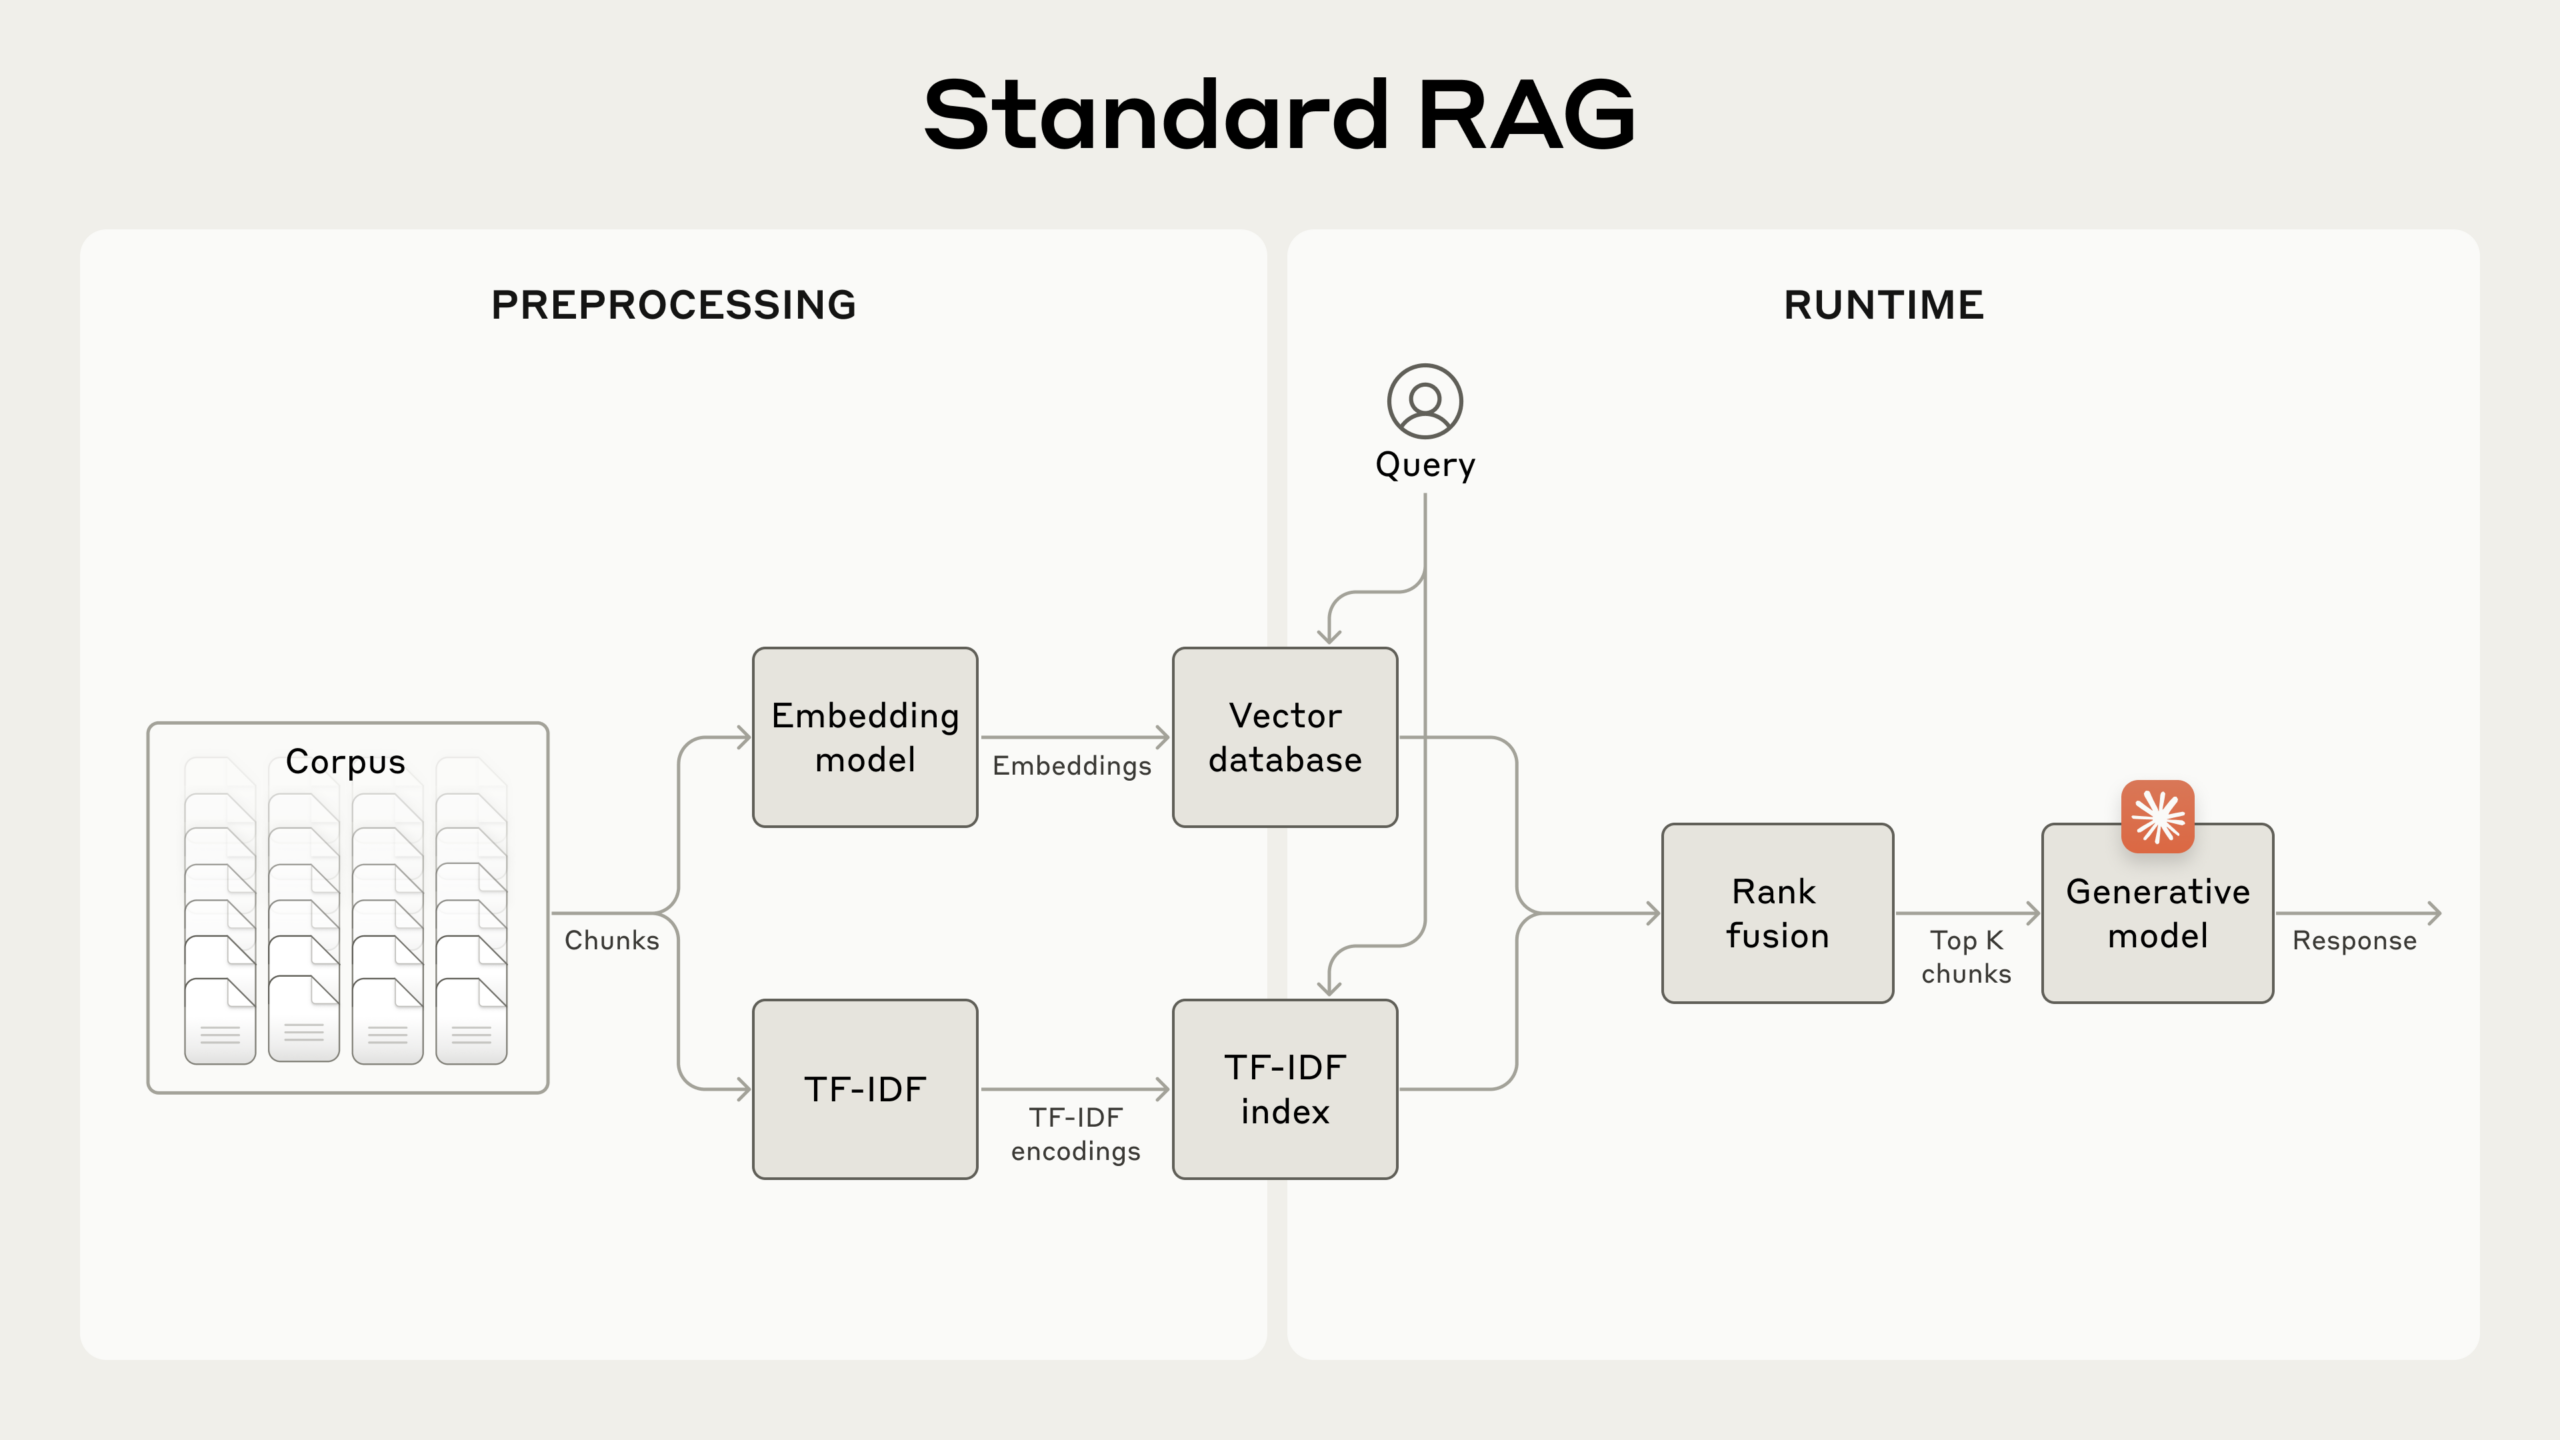
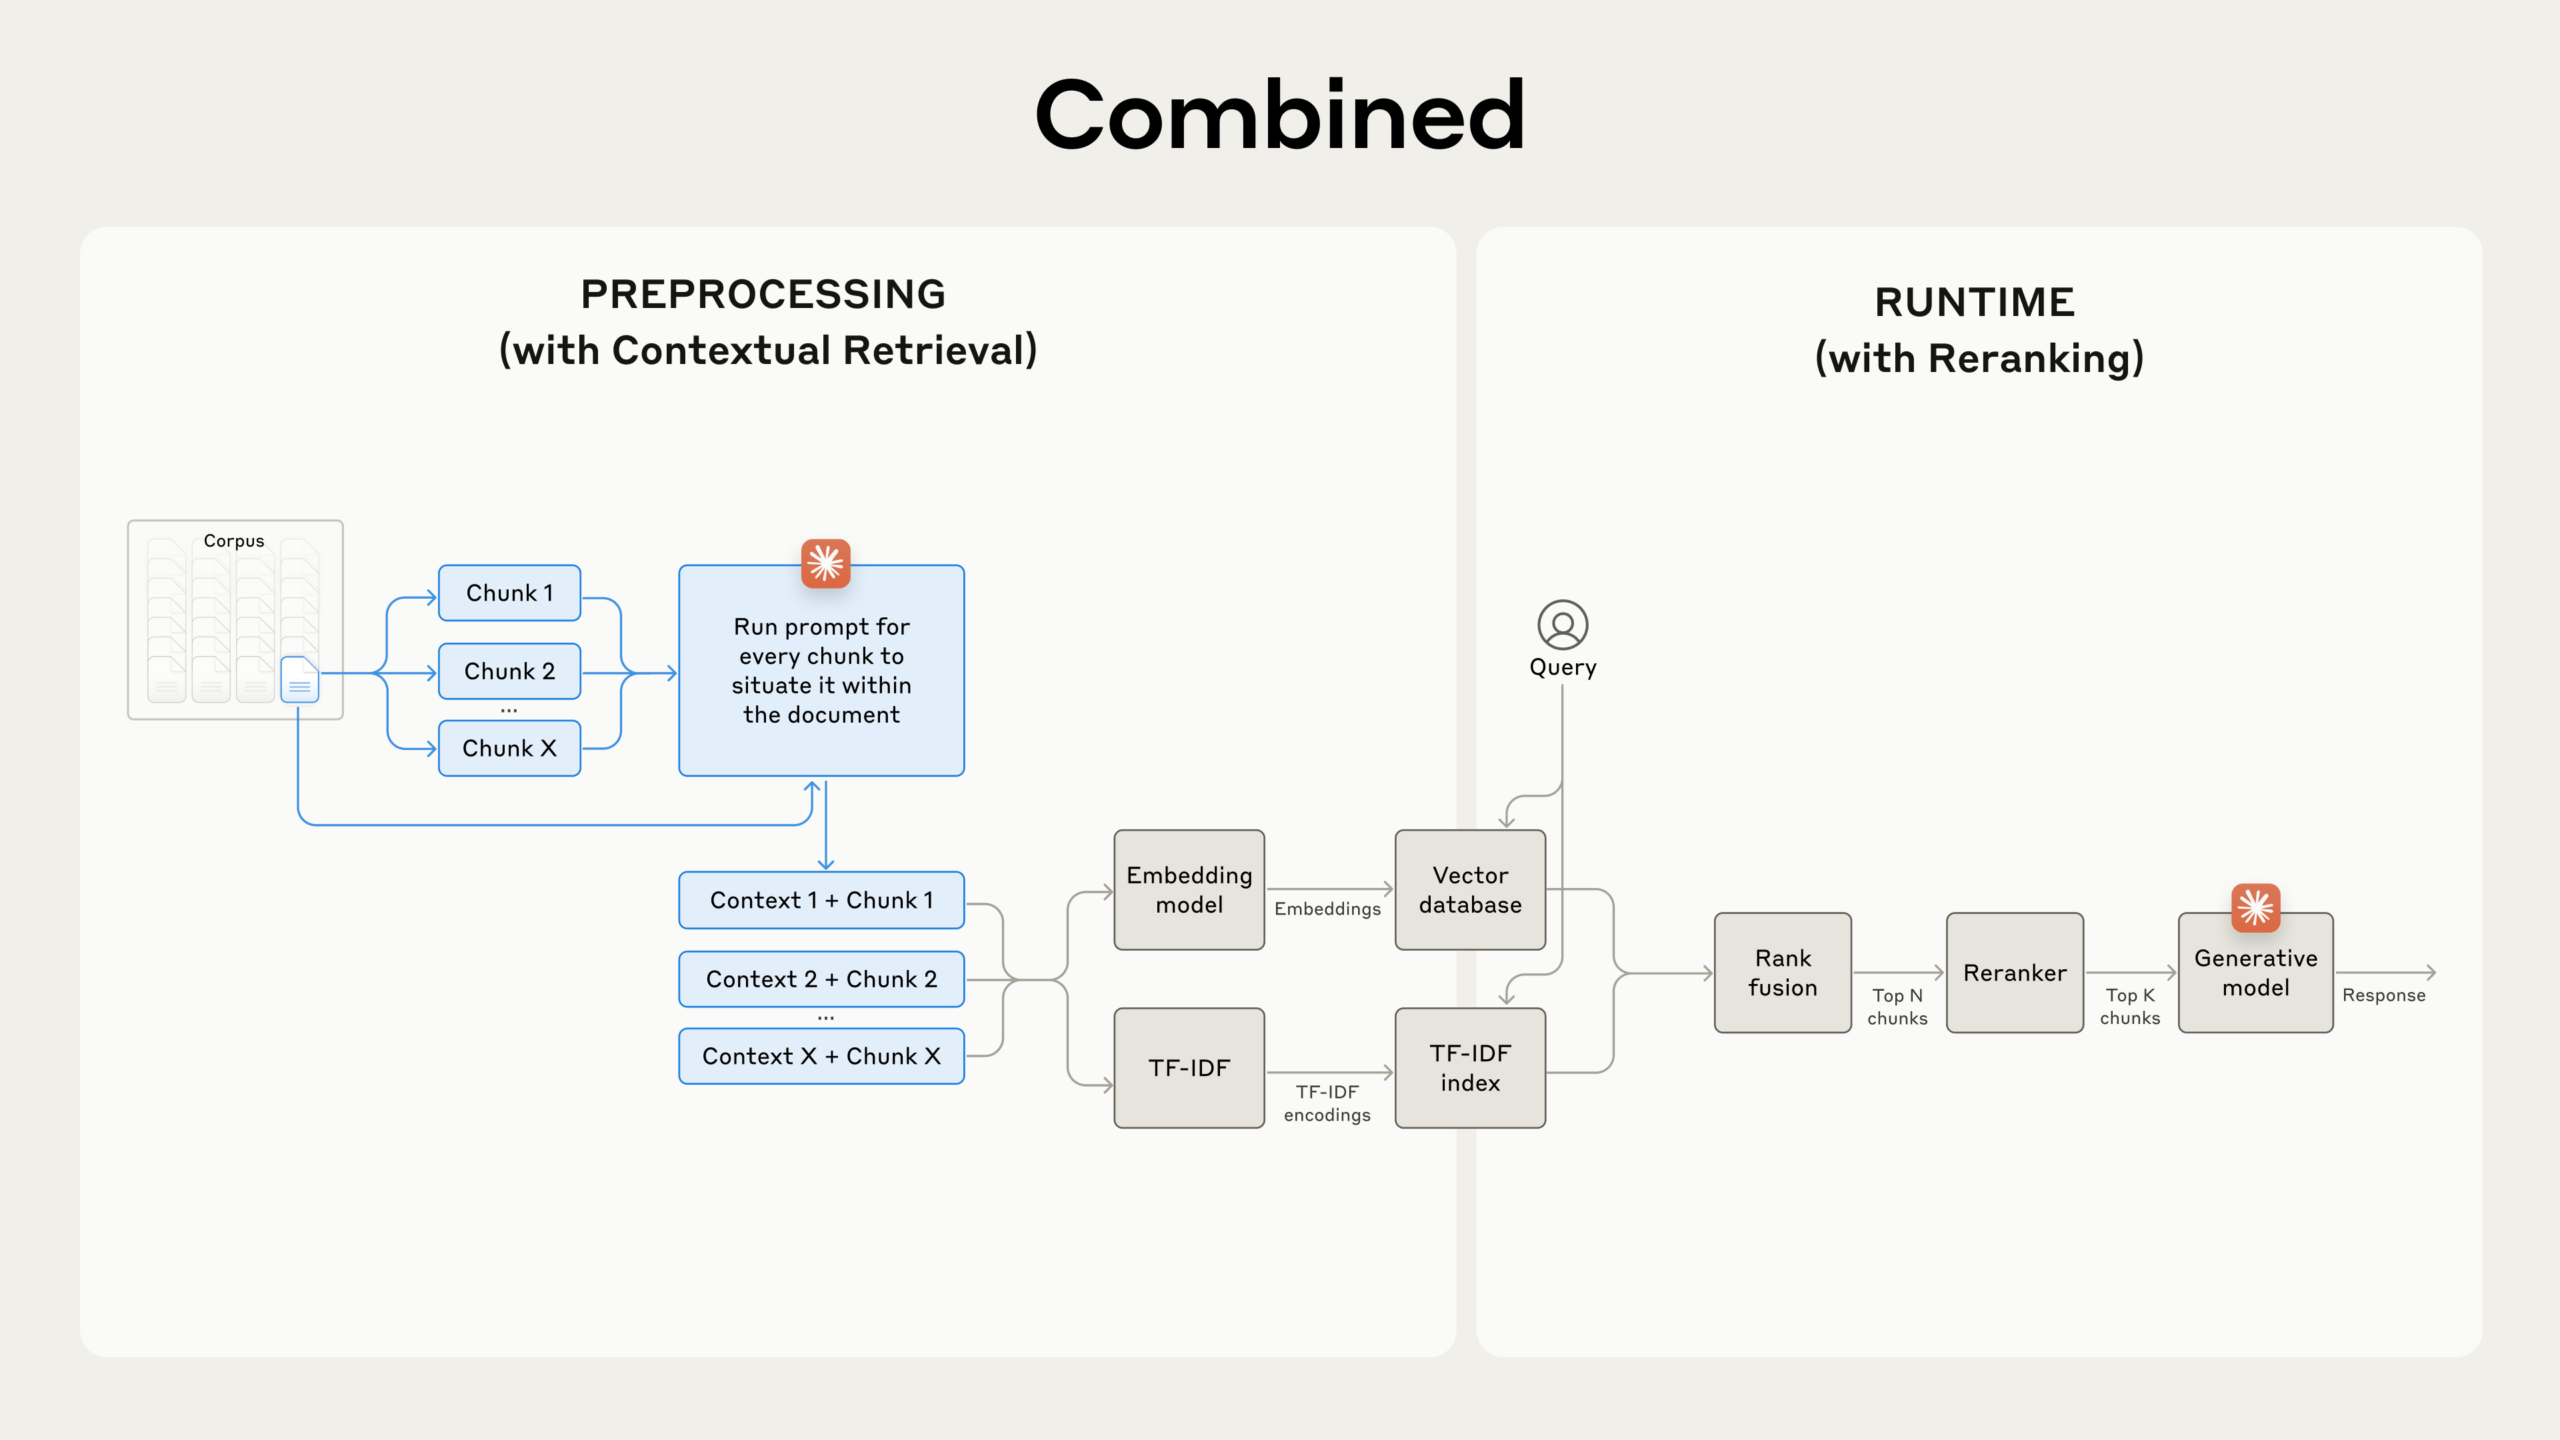
이렇게 나온 맥락은 보통 50~100토큰 길이입니다. 원문의 맥락 전처리 설명과 검색 단계 설명을 제가 하나로 이어 그리면 아래와 같아요. 앞의 네 단계는 미리 해 두는 전처리이고, 뒤의 두 단계는 질문이 들어올 때 일어납니다.
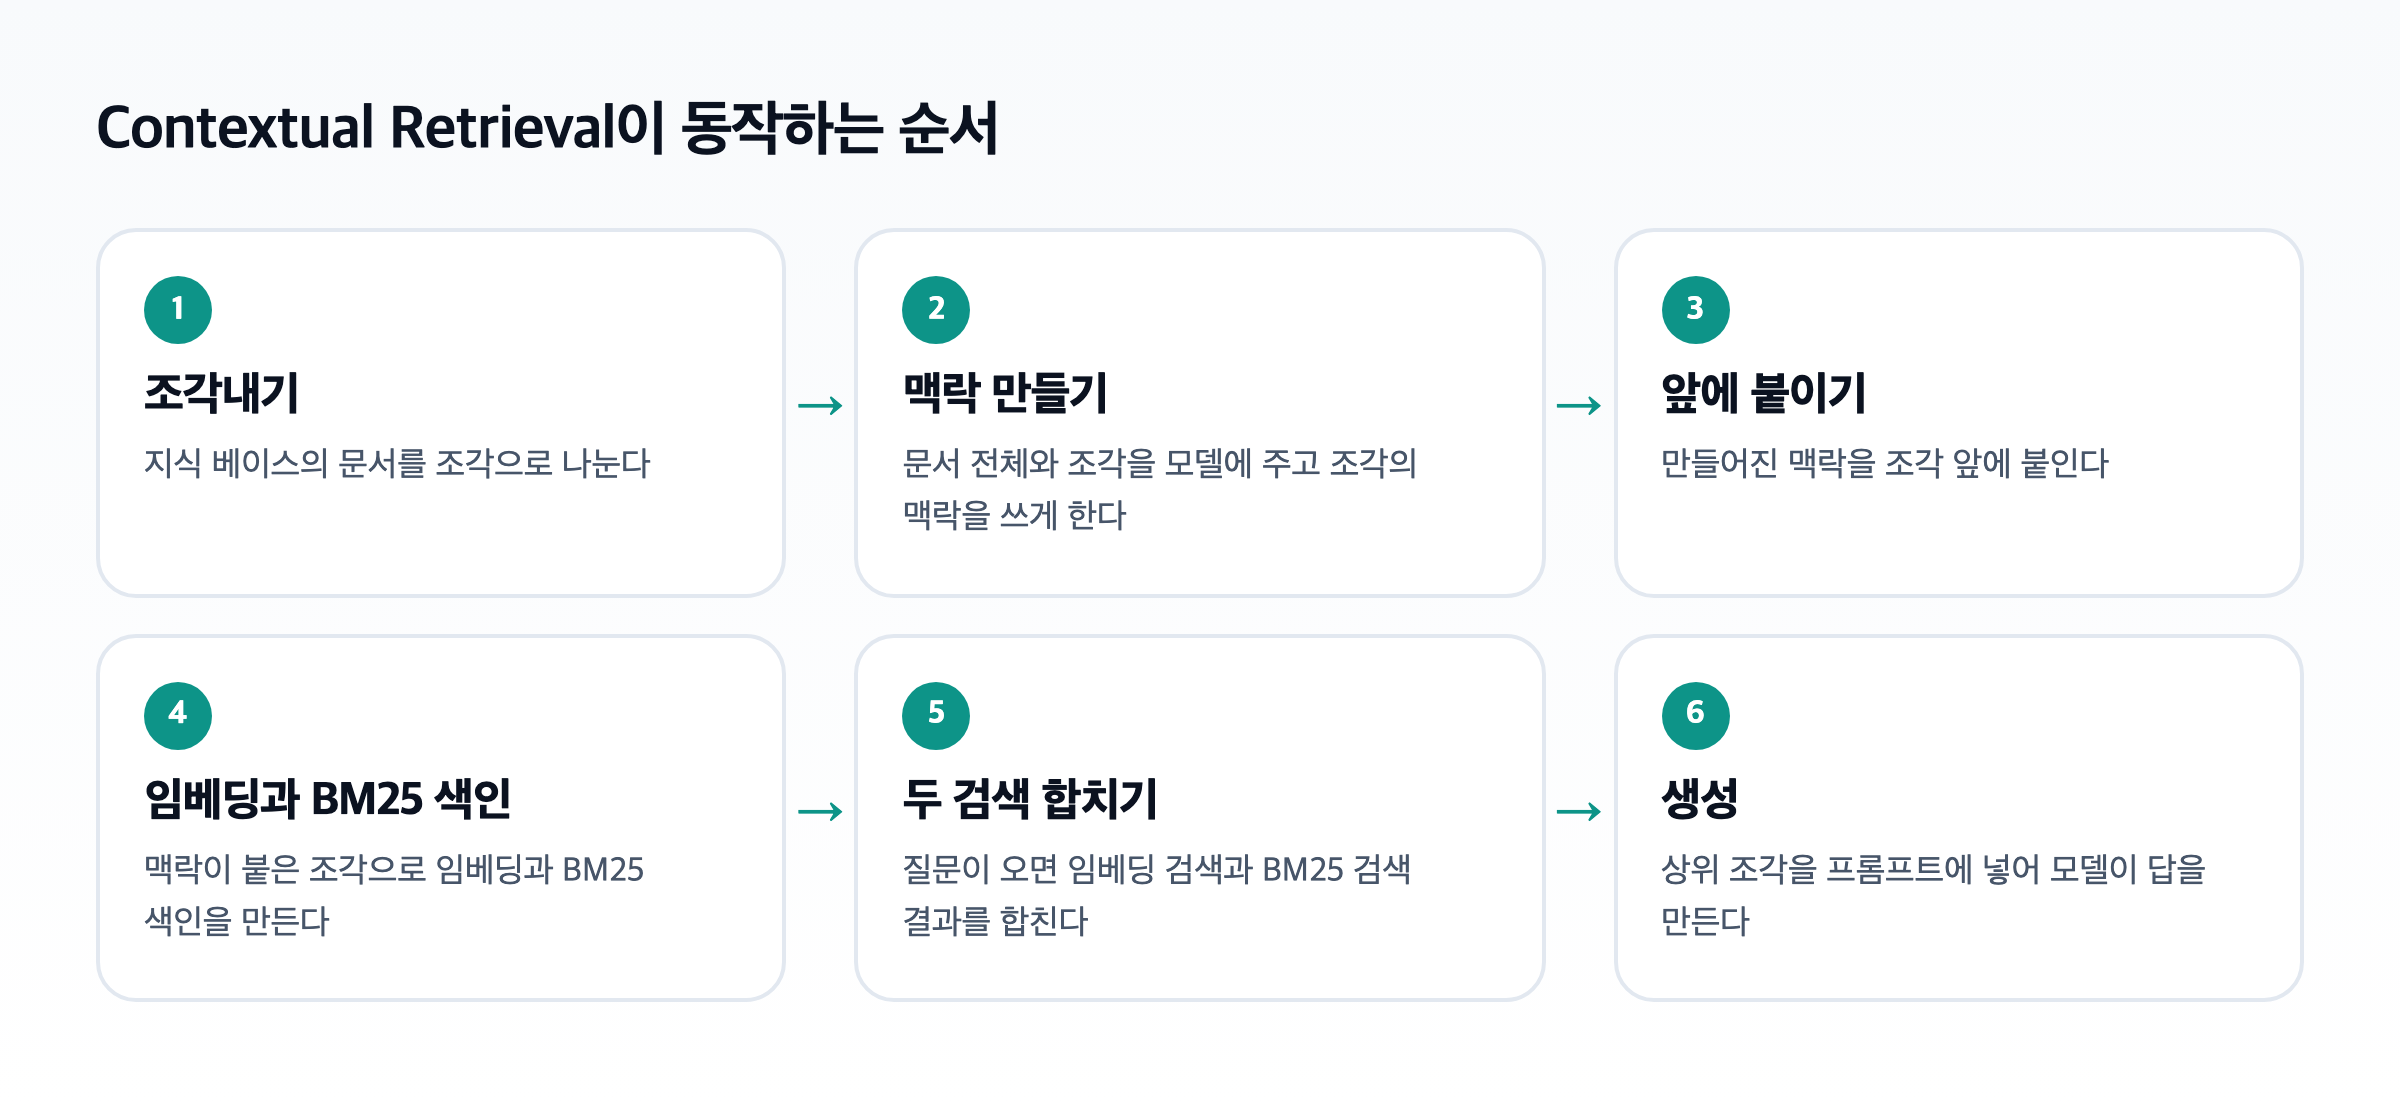
- 지식 베이스의 문서를 조각으로 나눈다
- 문서 전체와 조각 하나를 모델에 주고 그 조각의 맥락을 쓰게 한다
- 만들어진 맥락을 조각 앞에 붙인다
- 맥락이 붙은 조각으로 임베딩을 만들고 BM25 색인을 만든다
- 질문이 들어오면 임베딩 검색과 BM25 검색의 결과를 합치고 중복을 걸러 낸다
- 상위 조각을 프롬프트에 넣어 모델이 답을 만든다
5번과 6번은 원문이 임베딩과 BM25를 함께 쓰는 RAG의 순서로 설명한 부분입니다. BM25는 단어나 구절이 정확히 일치하는 것을 찾는 순위 함수인데, 임베딩 검색이 놓칠 수 있는 고유 식별자나 기술 용어를 잡아 주는 역할을 해요. 두 결과를 합칠 때는 순위 융합(rank fusion) 기법을 쓴다고 적혀 있습니다.
프롬프트 캐싱과의 관계
맥락을 만들 때는 조각과 함께 문서 전체를 모델에 줍니다. 원문은 프롬프트 캐싱을 쓰면 조각마다 문서를 넘길 필요가 없다고 설명해요. 문서를 캐시에 한 번 올려 두고, 그다음부터는 캐시된 내용을 참조하는 방식입니다. 원문은 이 기능이 있어서 낮은 비용으로 이 기법을 쓸 수 있다고 밝힙니다.
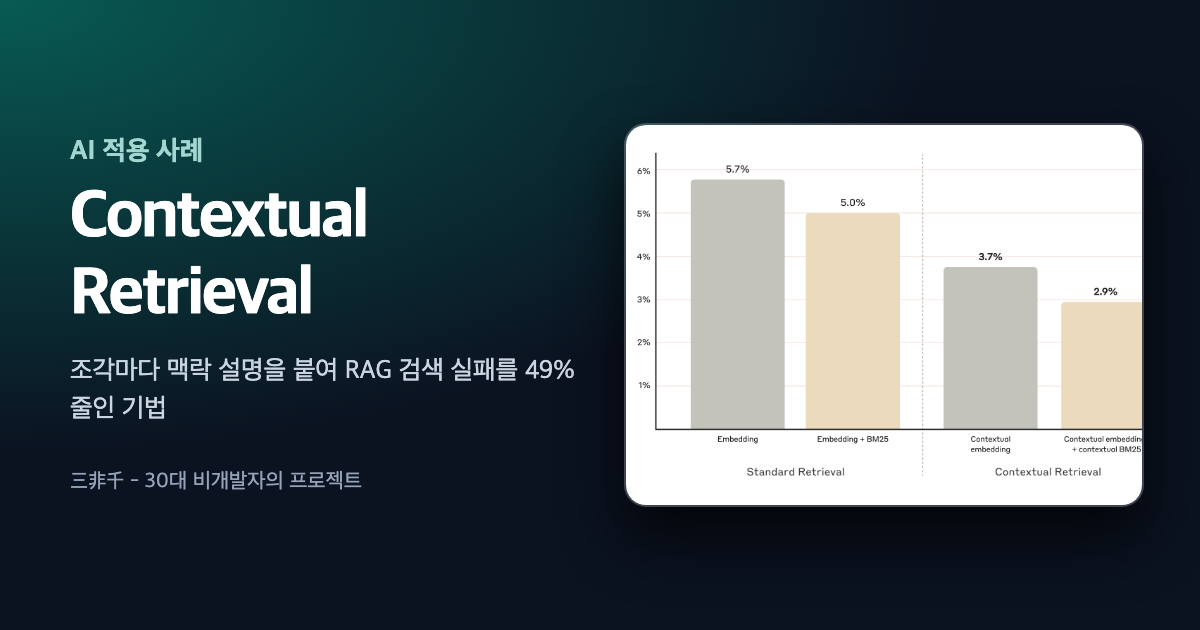
검색 실패율이 5.7%에서 2.9%로 내려갔다
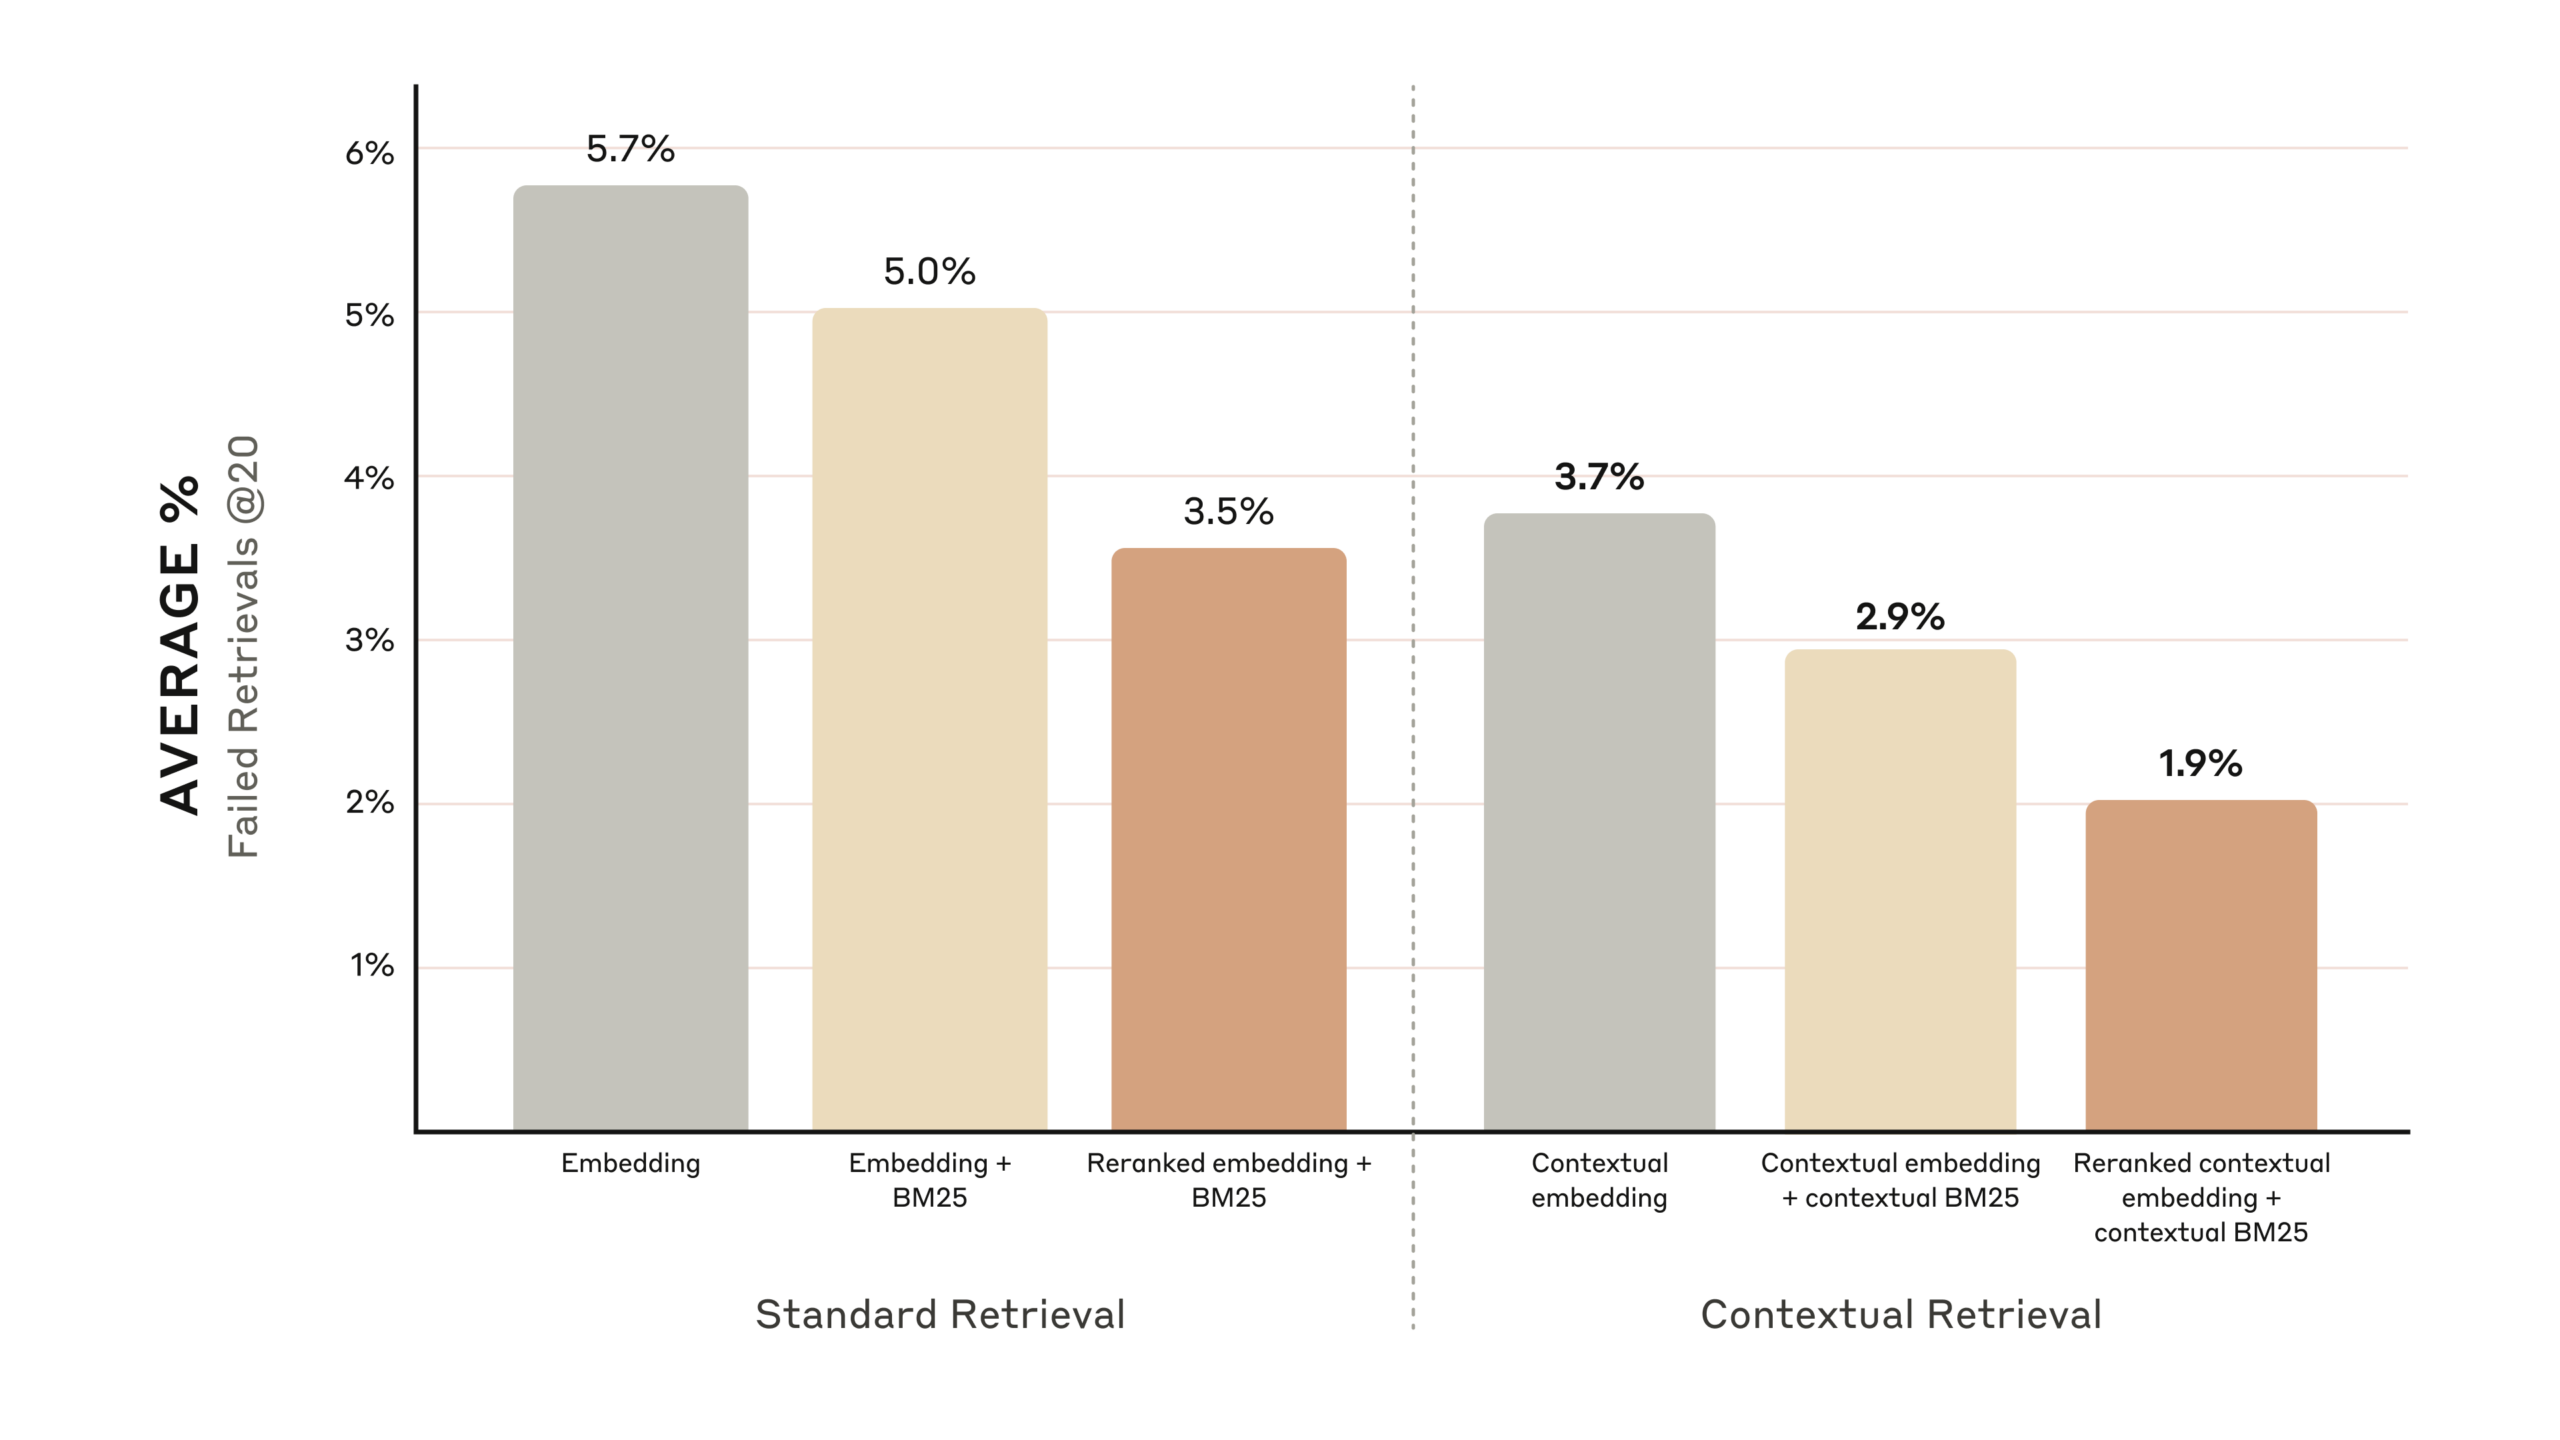
원문에 실린 Contextual Retrieval 실험 수치는 다음과 같습니다.
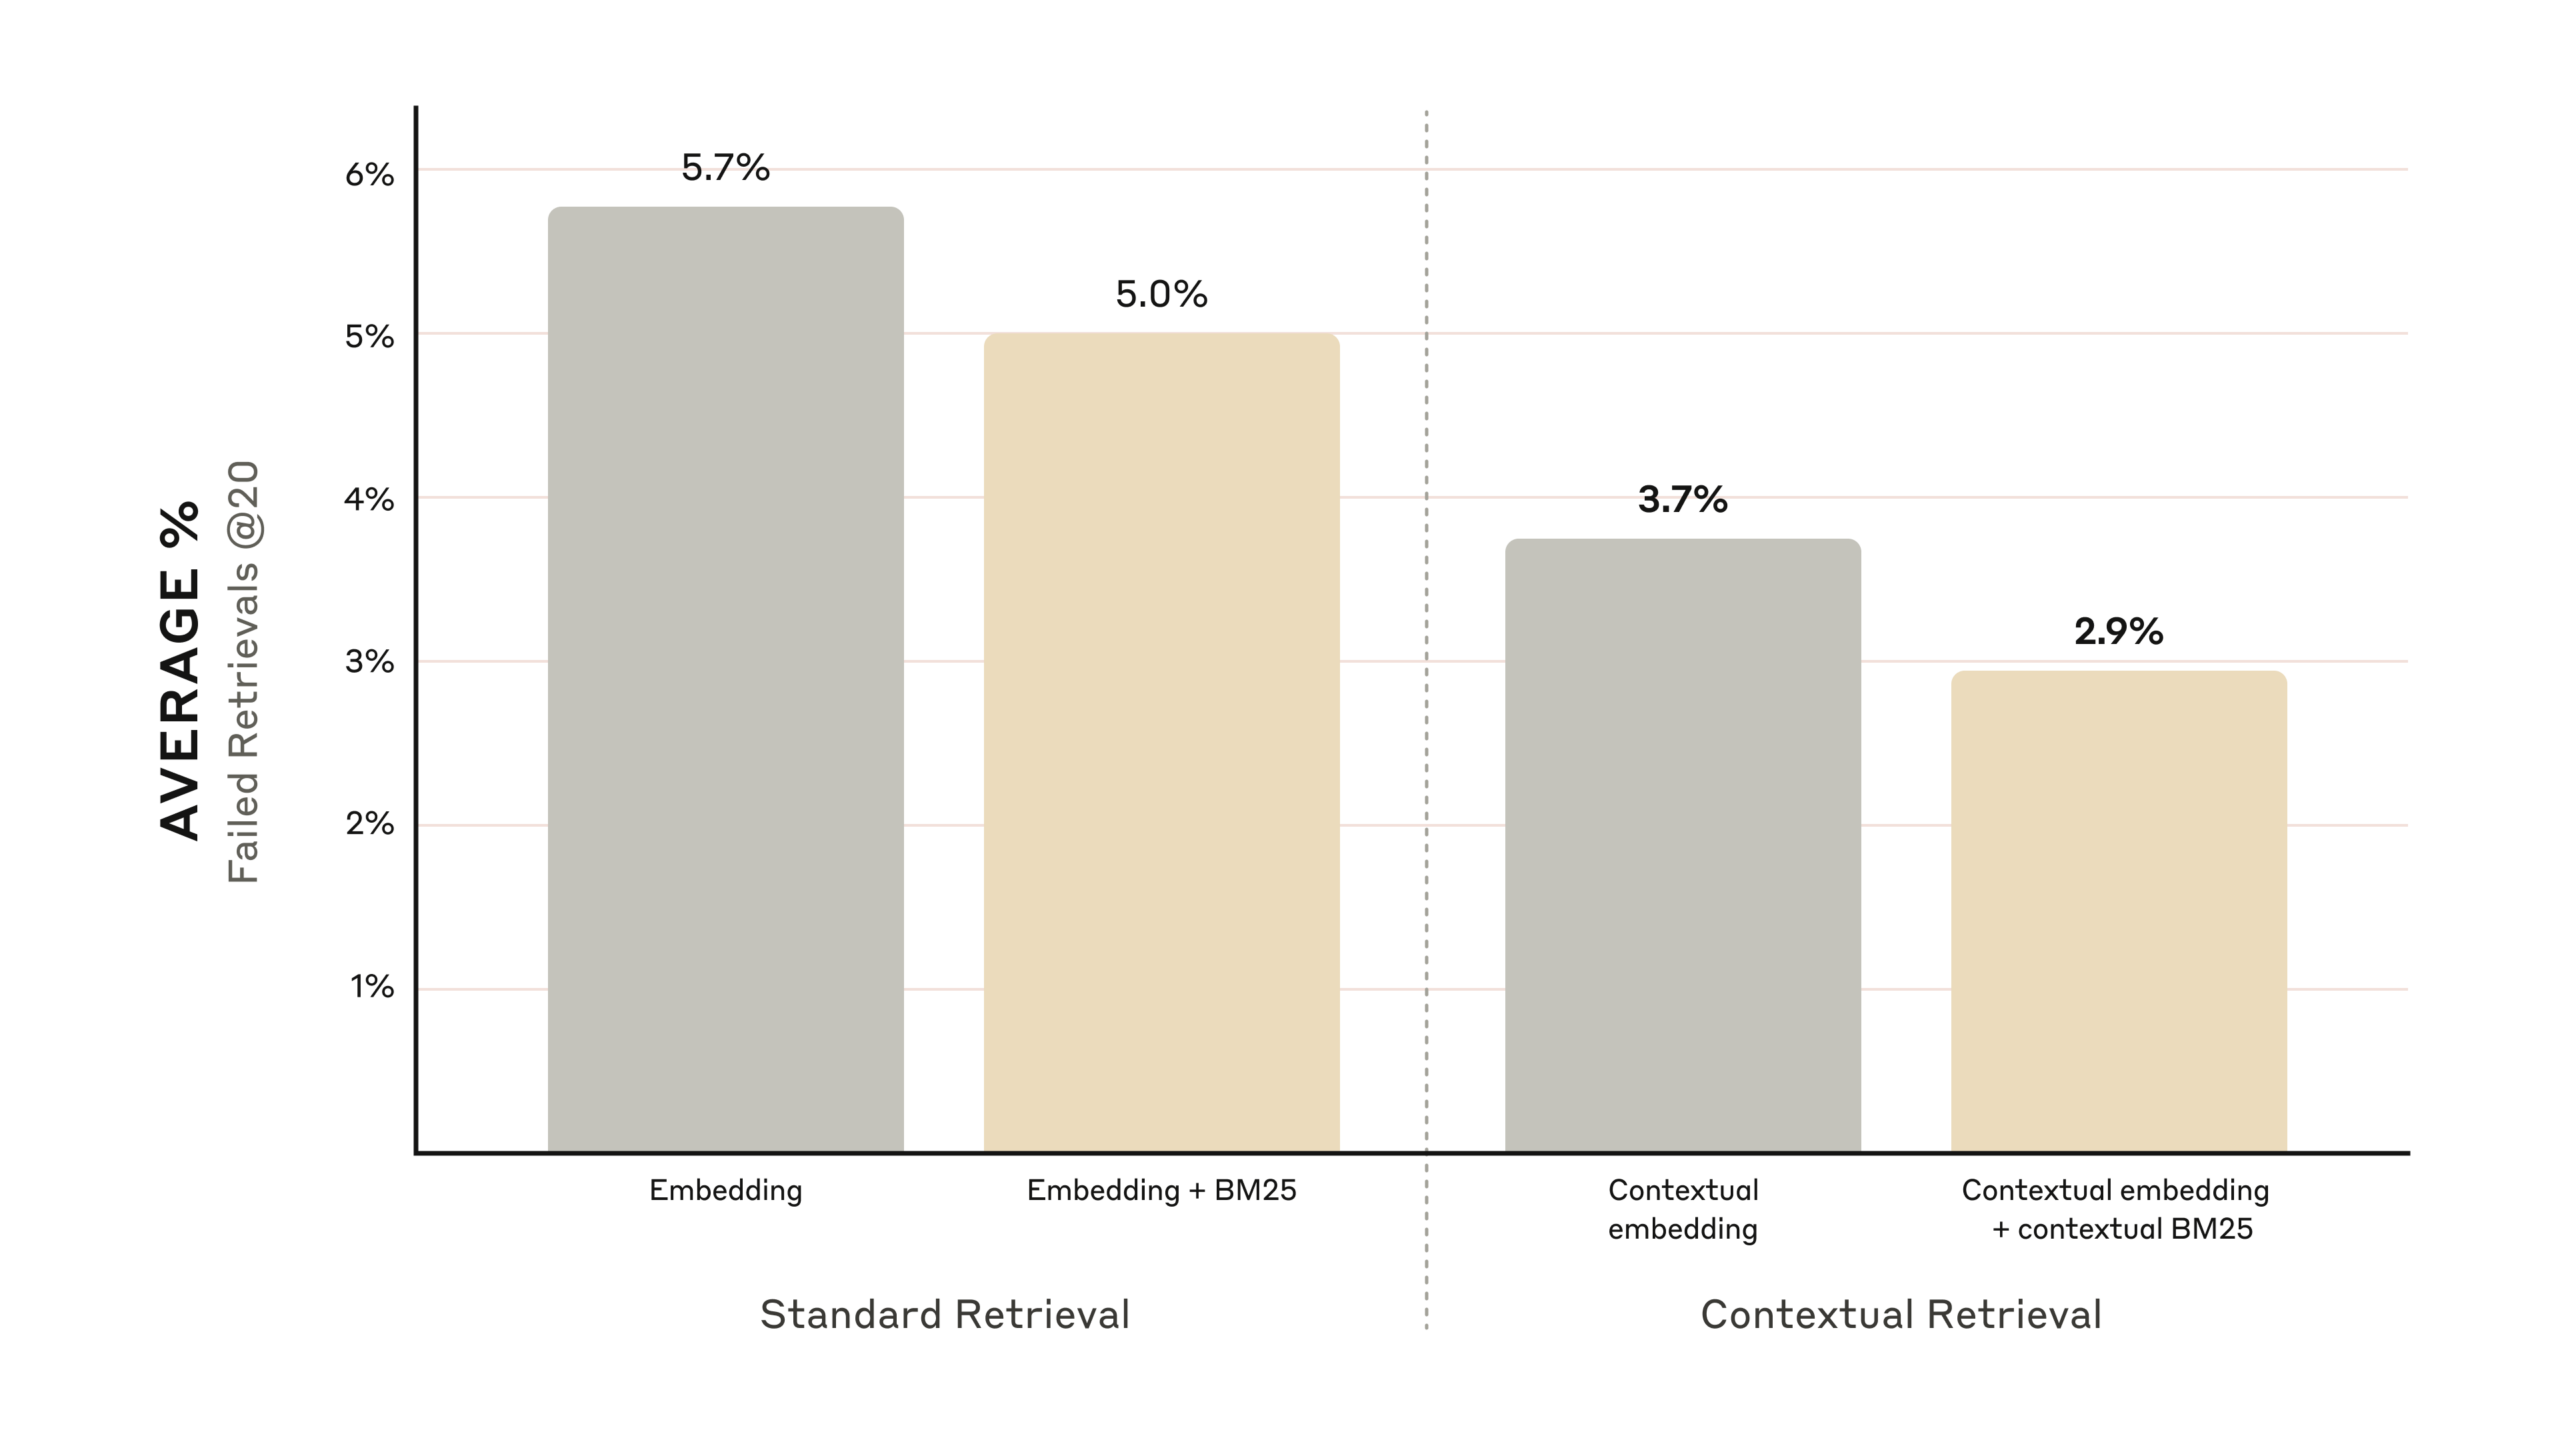
이 숫자를 읽으려면 측정 조건을 같이 봐야 합니다.
| 항목 | 원문에 적힌 조건 |
|---|---|
| 실험 분야 | 코드베이스, 소설, ArXiv 논문, 과학 논문 |
| 그래프의 값 | 전 분야 평균, 성적이 가장 좋았던 임베딩 구성(Gemini Text 004) |
| 가져온 조각 수 | 상위 20개 |
| 지표 | 1 − recall@20. 관련 문서가 상위 20개 조각 안에 들어오지 못한 비율 |
답변이 얼마나 정확해졌는지를 잰 숫자는 아니고, 검색 단계에서 필요한 문서를 놓친 비율을 잰 숫자예요. 원문은 검색 정확도의 향상이 뒤따르는 작업의 성능으로 바로 이어진다고 쓰고, 평가한 임베딩과 자료의 조합마다 맥락을 붙인 쪽이 성능이 좋았다고 덧붙입니다.
컨텍스트 엔지니어링 – AI가 읽는 양을 설계하는 방법재순위화를 더하면 150개에서 20개를 다시 고른다
Contextual Retrieval에 마지막으로 더하는 단계가 재순위화(reranking)입니다. 지식 베이스가 크면 1차 검색이 관련도가 제각각인 조각을 많이, 때로는 수백 개씩 돌려준다고 해요. 재순위화는 그중 가장 관련 있는 조각만 모델에 넘어가도록 걸러 내는 기법으로 소개됩니다.
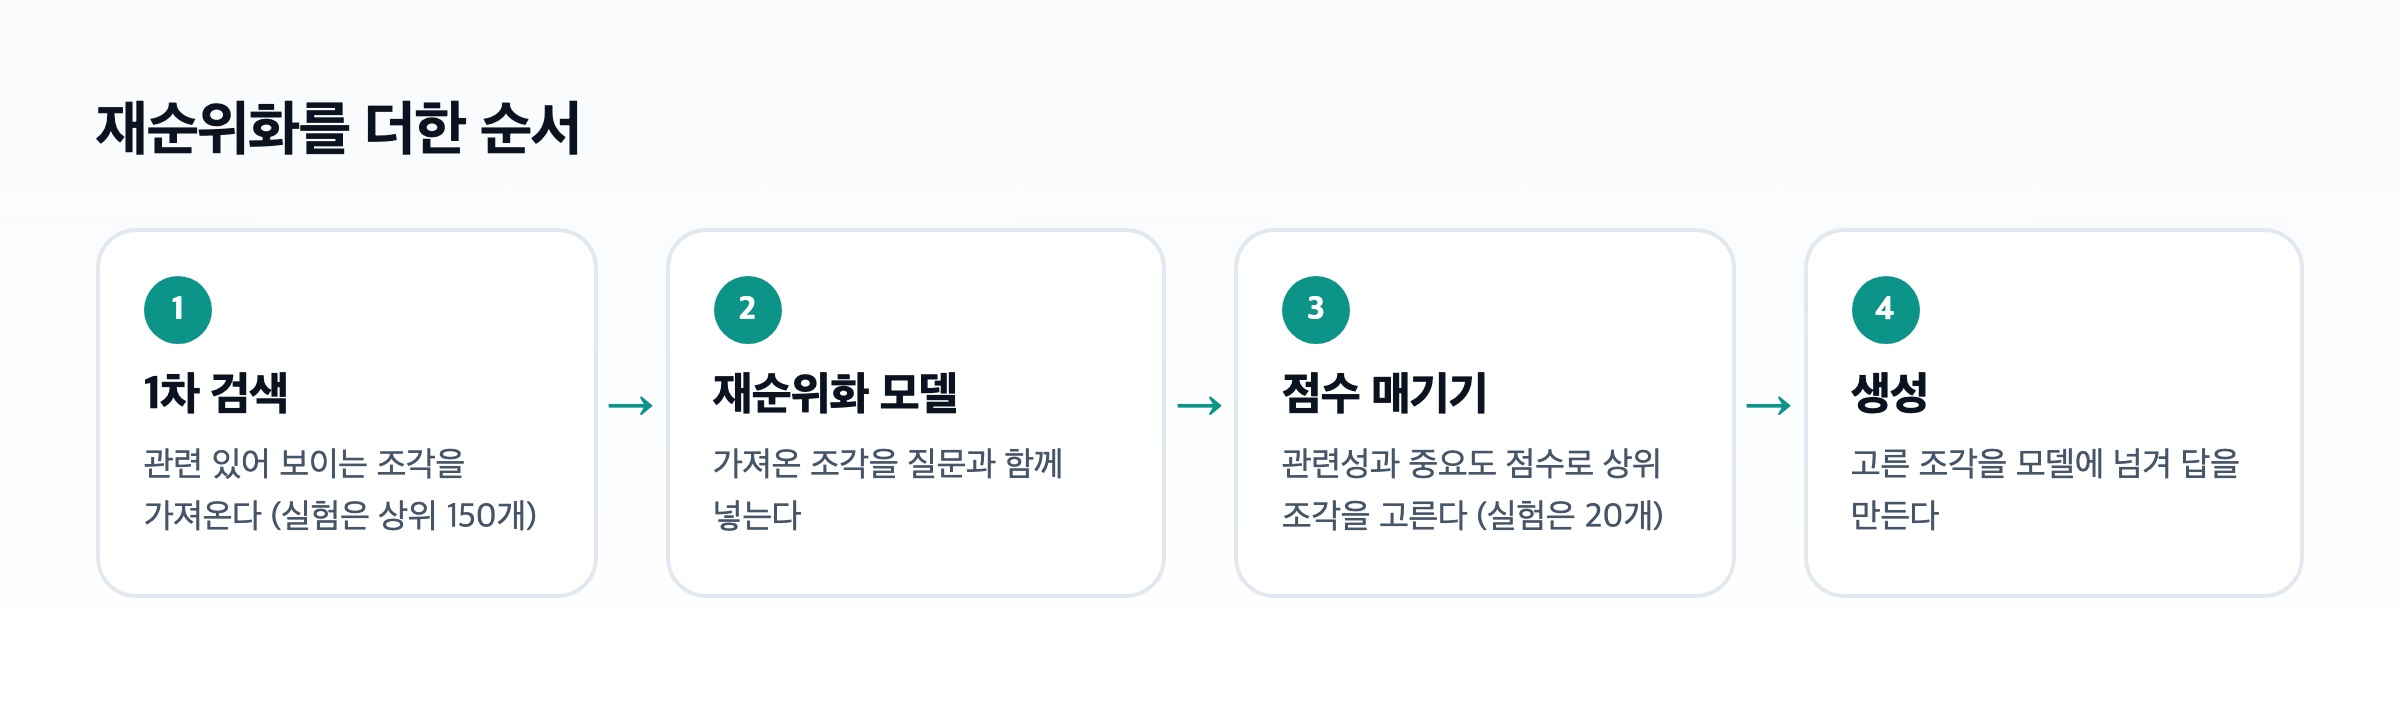
원문의 실험은 1차 검색에서 상위 150개를 가져와 질문과 함께 재순위화 모델에 넣었습니다. 이 모델이 조각마다 관련성과 중요도 점수를 매기고, 그중 상위 20개가 답을 만드는 모델로 넘어가요. 시험에 쓴 것은 Cohere의 재순위화 모델이고, 이 구성에서 실패율이 5.7%에서 1.9%로 내려갔습니다.
지연과 비용
재순위화는 질문이 들어올 때마다 한 단계가 더 도는 것이라 지연이 조금 늘어납니다. 원문은 더 많은 조각을 재순위화해 성능을 올리는 것과, 적게 해서 지연과 비용을 낮추는 것 사이에 맞바꿈이 있다고 적고, 쓰는 사례에 맞춰 설정을 실험해 보라고 권합니다.
구현할 때 원문이 짚는 것
원문은 Contextual Retrieval을 구현할 때 염두에 둘 것을 다섯 항목으로 듭니다.
| 항목 | 원문의 설명 |
|---|---|
| 조각 경계 | 조각의 크기, 경계, 겹침을 어떻게 정하느냐가 검색 성능에 영향을 줄 수 있다 |
| 임베딩 모델 | 시험한 모델에서 모두 성능이 올랐고, Gemini와 Voyage 임베딩이 특히 효과적이었다 |
| 맞춤 프롬프트 | 범용 프롬프트도 잘 동작하지만, 분야에 맞춘 프롬프트로 더 나은 결과를 얻을 수도 있다 |
| 조각 개수 | 5개, 10개, 20개를 넘겨 봤고 그중 20개의 성능이 가장 좋았다 |
| 평가 | 평가는 늘 돌린다 |
맞춤 프롬프트의 예로는 지식 베이스의 다른 문서에만 정의돼 있을 수 있는 핵심 용어의 용어집을 프롬프트에 넣는 경우를 듭니다. 조각 개수에는 단서가 붙어 있어요. 조각을 많이 넣을수록 관련 정보가 포함될 가능성은 커지지만, 정보가 많으면 모델의 주의가 흐트러질 수 있어서 한계가 있다는 겁니다. 20개가 가장 좋았다는 것도 시험한 세 가지 가운데서의 결과이고, 각자의 사례에서 실험해 볼 만하다고 적혀 있습니다.
평가 항목에는 답변 생성에 관한 제안이 하나 달려 있습니다. 맥락이 붙은 조각을 모델에 넘기면서 어디까지가 맥락이고 어디부터가 조각인지를 구분해 주면 답변이 나아질 수 있다는 내용이에요.
지식 베이스가 작으면 통째로 넣는다
원문은 기법을 설명하기에 앞서 더 단순한 길을 먼저 안내합니다. 지식 베이스가 20만 토큰(약 500쪽 분량)보다 작으면 전체를 프롬프트에 넣으면 되고 RAG나 비슷한 방법이 필요 없다는 거예요. 프롬프트 캐싱을 쓰면 이 방식이 훨씬 빠르고 비용 효율적이 된다고 덧붙입니다. Contextual Retrieval은 지식 베이스가 그보다 커져서 확장할 수 있는 방법이 필요할 때의 이야기로 소개됩니다.
이 사례에서 가져갈 만한 것
여기부터는 원문의 분류가 아니고 제가 읽으면서 정리한 것입니다.
- 문서를 조각내는 순간 사라지는 정보가 있다. 회사 이름이나 기간처럼 문서 전체에는 있지만 조각에는 없는 정보를 조각에 다시 적어 넣는 것이 이 기법의 내용이었습니다.
- 수치는 조건과 함께 읽는다. 49%와 67%는 상위 20개 조각 기준의 검색 실패율이고, 35%와 49%에는 여러 분야의 평균이라는 조건이 붙어 있습니다.
- 효과는 겹쳐 쌓인다. 원문의 결론은 맥락을 붙인 임베딩, 맥락을 붙인 BM25, 재순위화, 조각 20개를 함께 쓸 때 성능 향상이 가장 크다고 정리합니다.
- 규모가 작으면 검색 자체를 건너뛸 수 있다. 20만 토큰이라는 기준이 원문 앞쪽에 먼저 나옵니다.
참고로 제 프로젝트는 RAG를 쓰지 않고 목차 파일을 두고 필요한 문서를 찾아 읽는 방식을 씁니다. 그 얘기는 RAG 글에 적어 뒀고, 모델에게 무엇을 보여 줄지 고르는 일 전반은 컨텍스트 엔지니어링 글에서 다뤘습니다.
참고한 공식 자료
Introducing Contextual Retrieval (Anthropic, 2024년 9월 19일). 수치와 조건은 이 글에 적힌 것이고, 세부 결과는 원문의 부록에 있습니다.
Contextual Retrieval 자주 묻는 질문
Contextual Retrieval이 뭔가요?
Anthropic이 2024년 9월 19일에 공개한 검색 개선 기법입니다. 문서 조각을 임베딩하거나 BM25 색인을 만들기 전에, 그 조각이 전체 문서에서 어떤 대목인지 설명하는 짧은 맥락을 조각 앞에 붙입니다.
검색 실패율이 얼마나 줄었나요?
Anthropic의 글에 따르면 맥락을 붙인 임베딩과 맥락을 붙인 BM25를 함께 썼을 때 상위 20개 조각 기준 검색 실패율이 5.7%에서 2.9%로 49% 줄었고, 재순위화를 더하면 1.9%로 67% 줄었습니다. 답변 정확도가 아닌 검색 단계에서 잰 수치입니다.
지식 베이스가 작아도 이 기법이 필요한가요?
같은 글은 지식 베이스가 20만 토큰(약 500쪽)보다 작으면 전체를 프롬프트에 넣으면 되고 RAG나 비슷한 방법이 필요 없다고 안내합니다. 지식 베이스가 그보다 커질 때 필요한 방법으로 이 기법을 소개합니다.
글에 나온 규칙 파일과 에이전트는 Claude Code에서 쓰는 방식이고, 공식 안내는 Claude Code 공식 문서에 있습니다.
이 글은 직접 만들고 운영하며 남긴 기록입니다. 적힌 수치는 작성 시점의 제 계정 기준이며, 같은 결과나 수익을 보장하지 않습니다.
3 Comments