의사결정 모델(Decision Model) – 문장 대신 선택과 확률을 돌려주는 AI
의사결정 모델(Decision Model)은 문장을 써 주는 대신, 미리 정해 둔 선택지 가운데 하나와 그 확률처럼 형식이 정해진 값을 돌려주는 차세대 AI 모델입니다. 2026년 9월 15일 TypeSafe AI가 Jev를 공개했고, 10월 1일에는 Cloudflare가 Clef와 Clef-flash를, 10월 6일에는 OpenAI가 Decisions API를 베타로 냈어요.
부르는 이름은 조금씩 다릅니다. TypeSafe는 자기 모델 부류를 대니얼 카너먼의 직관적 판단 이론에서 따와 시스템 원 모델(System One Model)이라 하고, Cloudflare 공식 블로그는 이 흐름을 decision model이라고 부릅니다. 세 곳의 의사결정 모델은 판단할 상태와 질문을 보내고 타입이 정해진 답과 확률을 받는 구성이 같습니다. 각 회사의 공식 문서와 벤치마크 데이터를 확인해, 작동 원리와 속도·비용 차이, 실제 연동 방식을 정리했습니다.
의사결정 모델이 돌려주는 값과 세 가지 질문 유형
TypeSafe 문서는 시스템 원 모델을 “소프트웨어가 바로 쓸 수 있는 빠르고 구조화된 결정을 내리도록 만든 AI 모델 부류”로 정의합니다. LLM처럼 자연어 입력을 이해하지만, 생성한 글 대신 타입(Type)이 정해진 결정과 확률을 돌려준다는 설명이 이어져요.
Cloudflare의 정의도 같은 방향입니다. 의사결정 모델은 에이전트가 어떻게 행동할지 정하도록 확률을 바탕으로 분류해 주는 모델이라고 하고, 고객 문의 메시지를 넣어 급한지와 어느 팀이 맡을지를 묻는 예를 듭니다. 돌아온 답으로 코드가 문의를 배정하거나, 상위 단계로 올리거나, 사람에게 넘깁니다.
의사결정 모델에 물을 수 있는 질문의 유형은 정해져 있고, 세 회사 문서에서 공통으로 셋입니다.
| 질문 유형 | 묻는 것 | 돌아오는 값 | 대표 용례 |
|---|---|---|---|
참·거짓 (noul / predicate) |
이 조건이 참인가 | 참일 확률 (0.0 ~ 1.0) | 악성 프롬프트 탐지, 가드레일, 결제 오류 여부 |
선택 (choice) |
주어진 선택지 중 어느 것인가 | 고른 값, 선택지별 확률, 신뢰도 | 고객 문의 부서 배정, 도구 라우팅, 감정 분류 |
점수 (score) |
순서가 있는 단계 중 어디쯤인가 | 점수 (가중 평균치), 단계별 확률 | 고객 불만 심각도 (1~5), 검색 문서 관련성 |
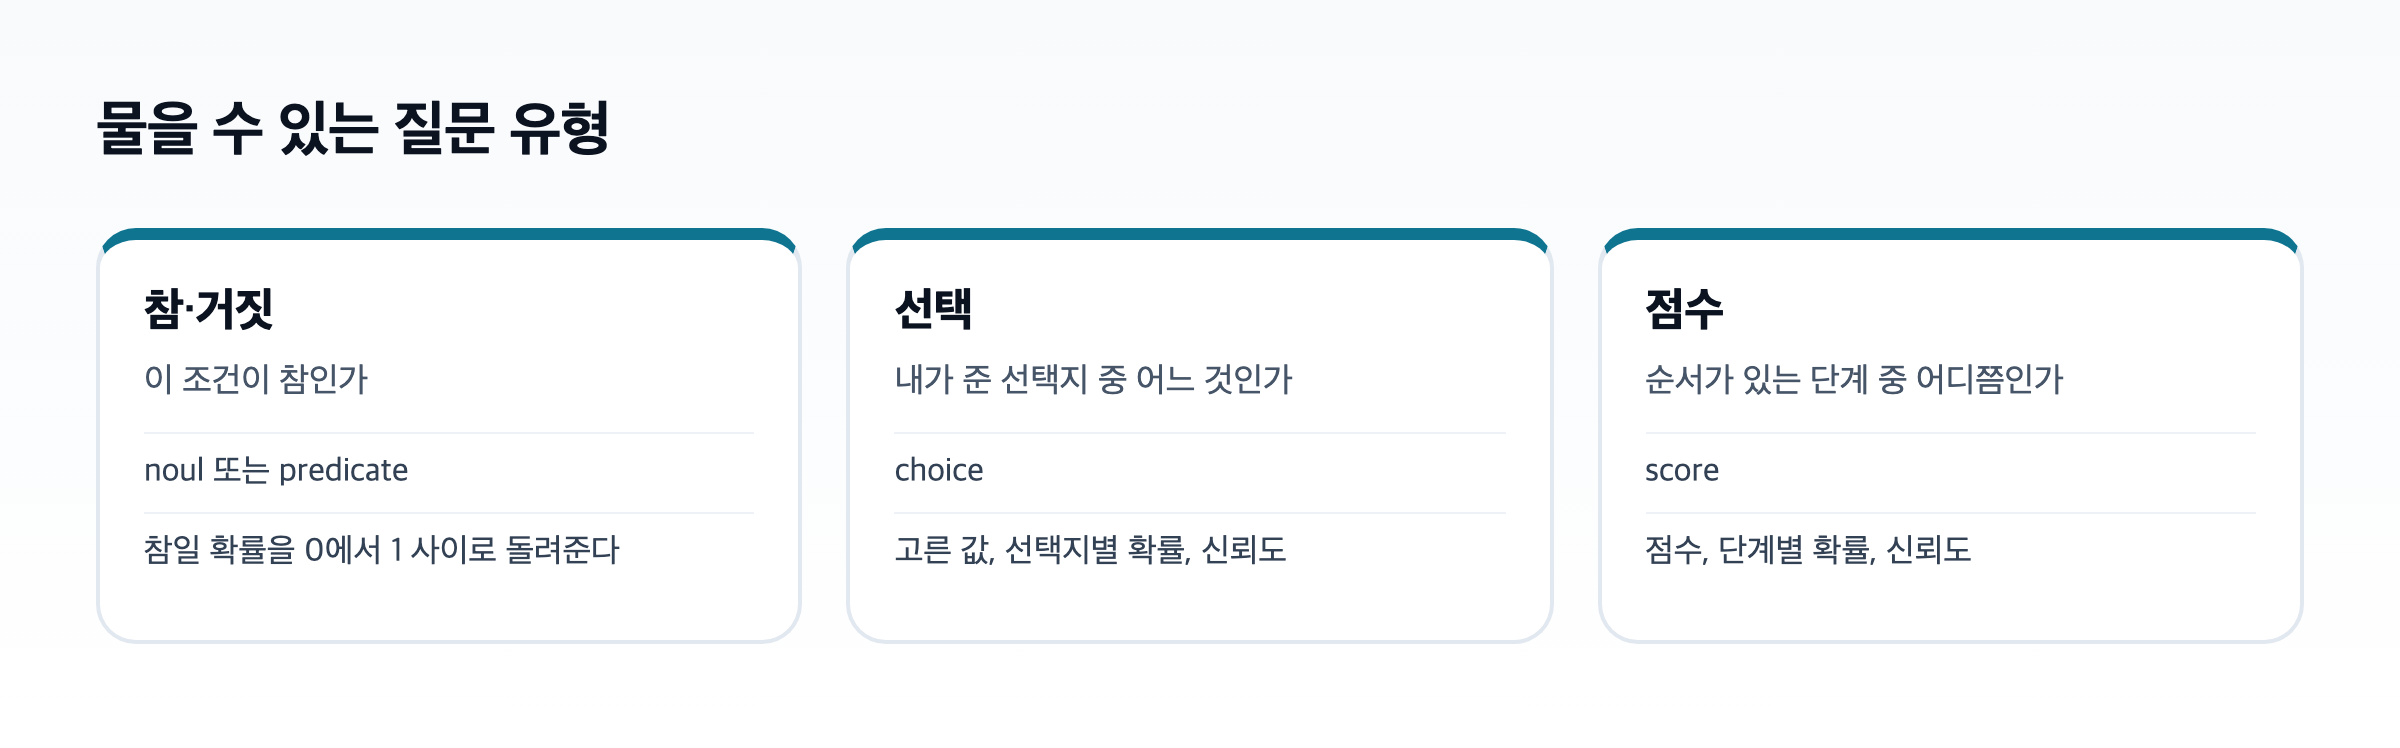
OpenAI와 Cloudflare 문서 기준으로 점수는 단계 번호를 확률로 가중 평균한 값입니다. 예컨대 0·1·2번 단계의 확률이 각각 0.1, 0.7, 0.2라면 1.1이 계산되어 나옵니다. 이 덕분에 이산적인 단계 사이의 미세한 심각도나 관련성 차이를 수치로 정밀하게 읽어낼 수 있어요.
요청에는 상태와 질문을 넣는다
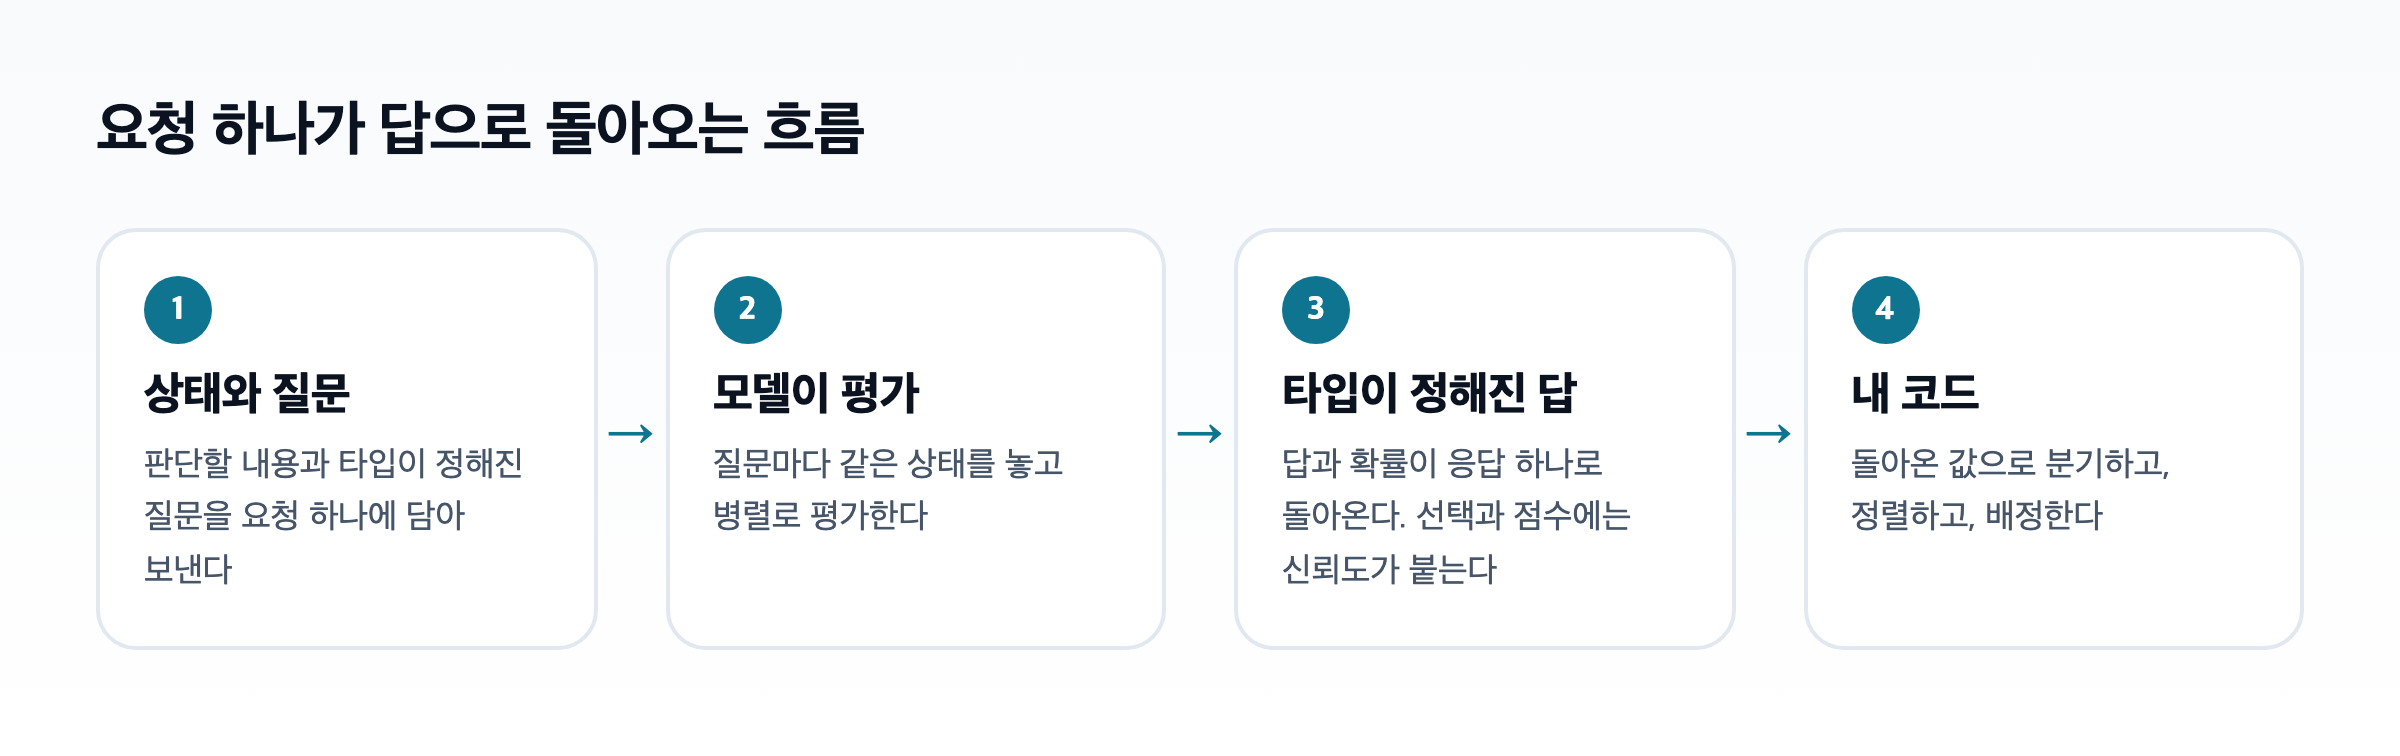
일반 LLM 호출은 대화 메시지를 보내고 글을 받습니다. 반면 의사결정 모델 호출은 판단할 내용과 질문 목록을 함께 전달해요. TypeSafe와 Cloudflare는 판단할 내용을 state, OpenAI는 input이라고 부르고, 질문은 세 곳 다 questions에 담습니다.
OpenAI 공식 가이드에 실린 cURL 요청 예시입니다. 고객 불만 한 줄을 넣고 어느 부서가 맡을지 묻습니다.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'
이 요청에 대해 모델이 돌려주는 응답 형태입니다.
{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
결과에는 지정한 선택지 중 하나인 "billing"이 들어가고, 선택지별 확률과 전체 신뢰도가 함께 붙습니다. 준비한 선택지가 모든 상황을 포괄하지 못할 때를 대비해 "other" 같은 예비 항목을 열어두는 패턴을 공식 가이드가 권장해요.
왜 수십 배 빠르고 출력 토큰이 무료인가: 단일 순전파(Single Forward Pass)
의사결정 모델이 기존 생성형 LLM과 완전히 차별화되는 지점은 내부 추론 아키텍처에 있습니다.
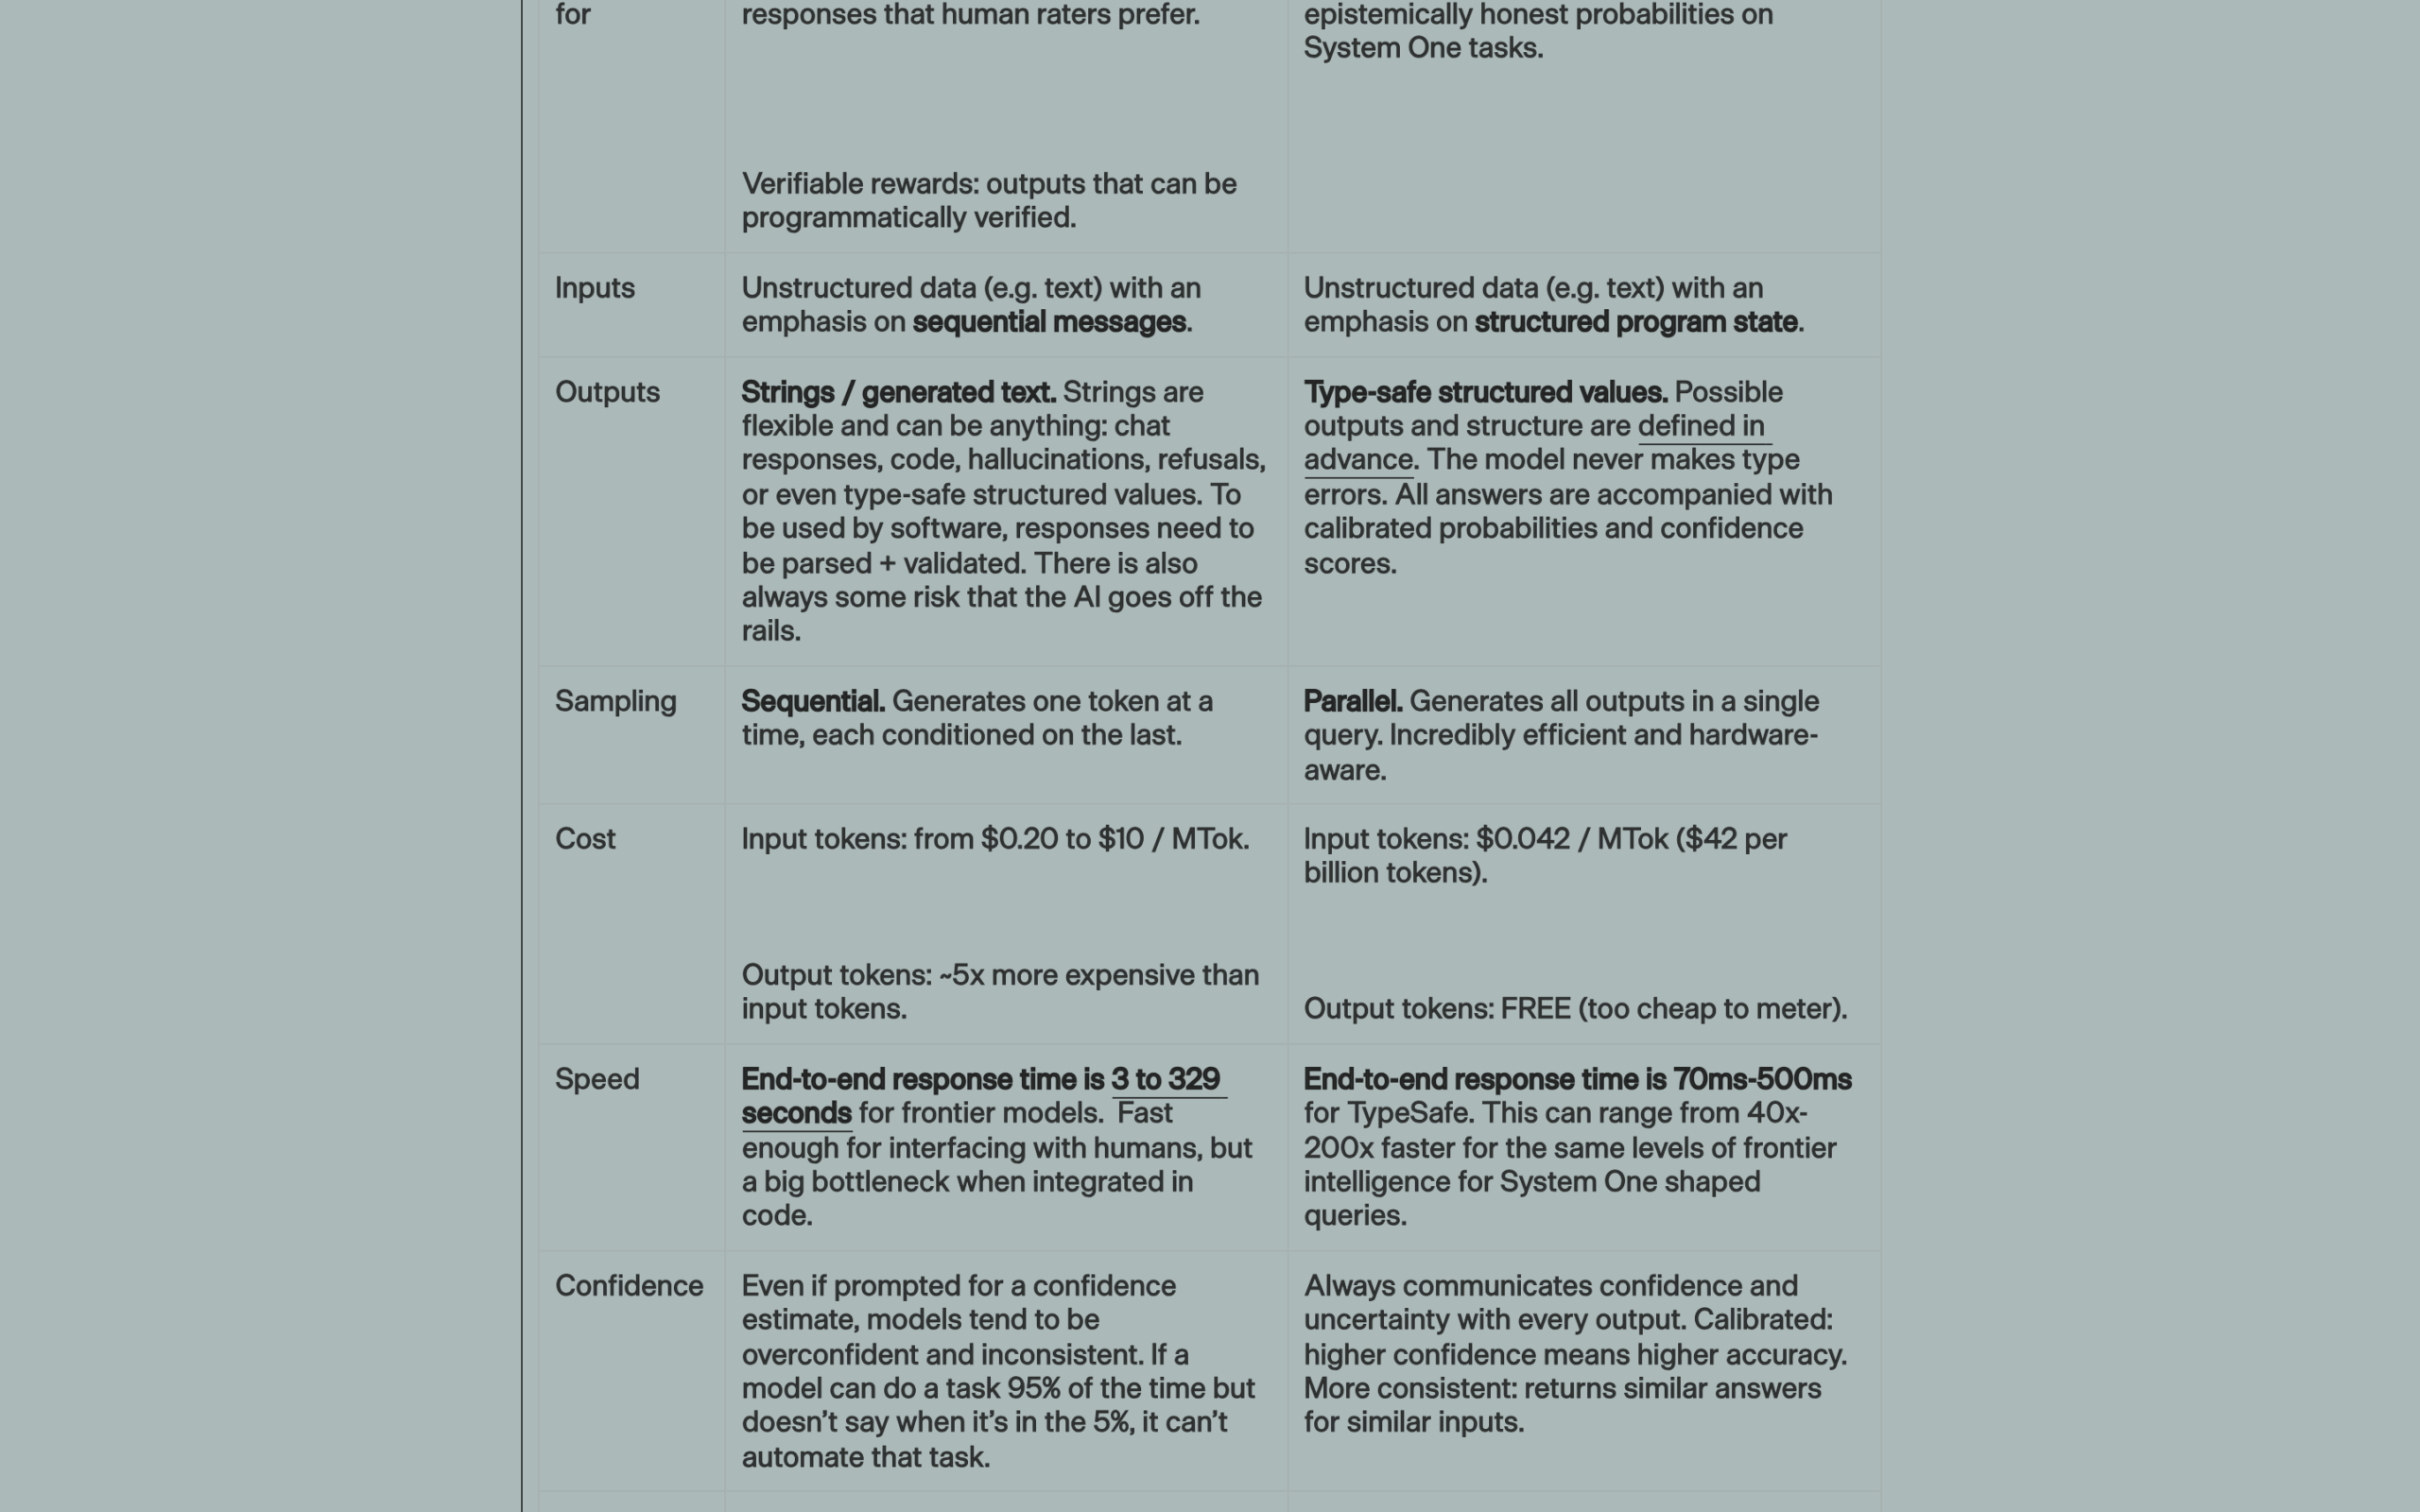
기존 LLM은 자기회귀(Autoregressive) 방식을 씁니다. 단어를 한 토큰씩 순차적으로 예측하고, 방금 나온 토큰을 다시 입력에 붙여 다음 토큰을 뽑는 과정을 끝날 때까지 반복합니다. 이 때문에 답변이 길어질수록 3초에서 30초 이상의 지연 시간이 걸리고, 출력 토큰마다 비싼 컴퓨팅 비용이 청구됩니다. 또한 JSON 스키마를 지키라고 지시해도 따옴표나 괄호가 누락되어 구문 분석 오류(Syntax Error)가 터질 위험이 항상 도사립니다.
반면 의사결정 모델은 Hugging Face Clef 모델 카드가 밝히듯 단 한 번의 순전파(Single Forward Pass)로 모든 결정을 끝냅니다.
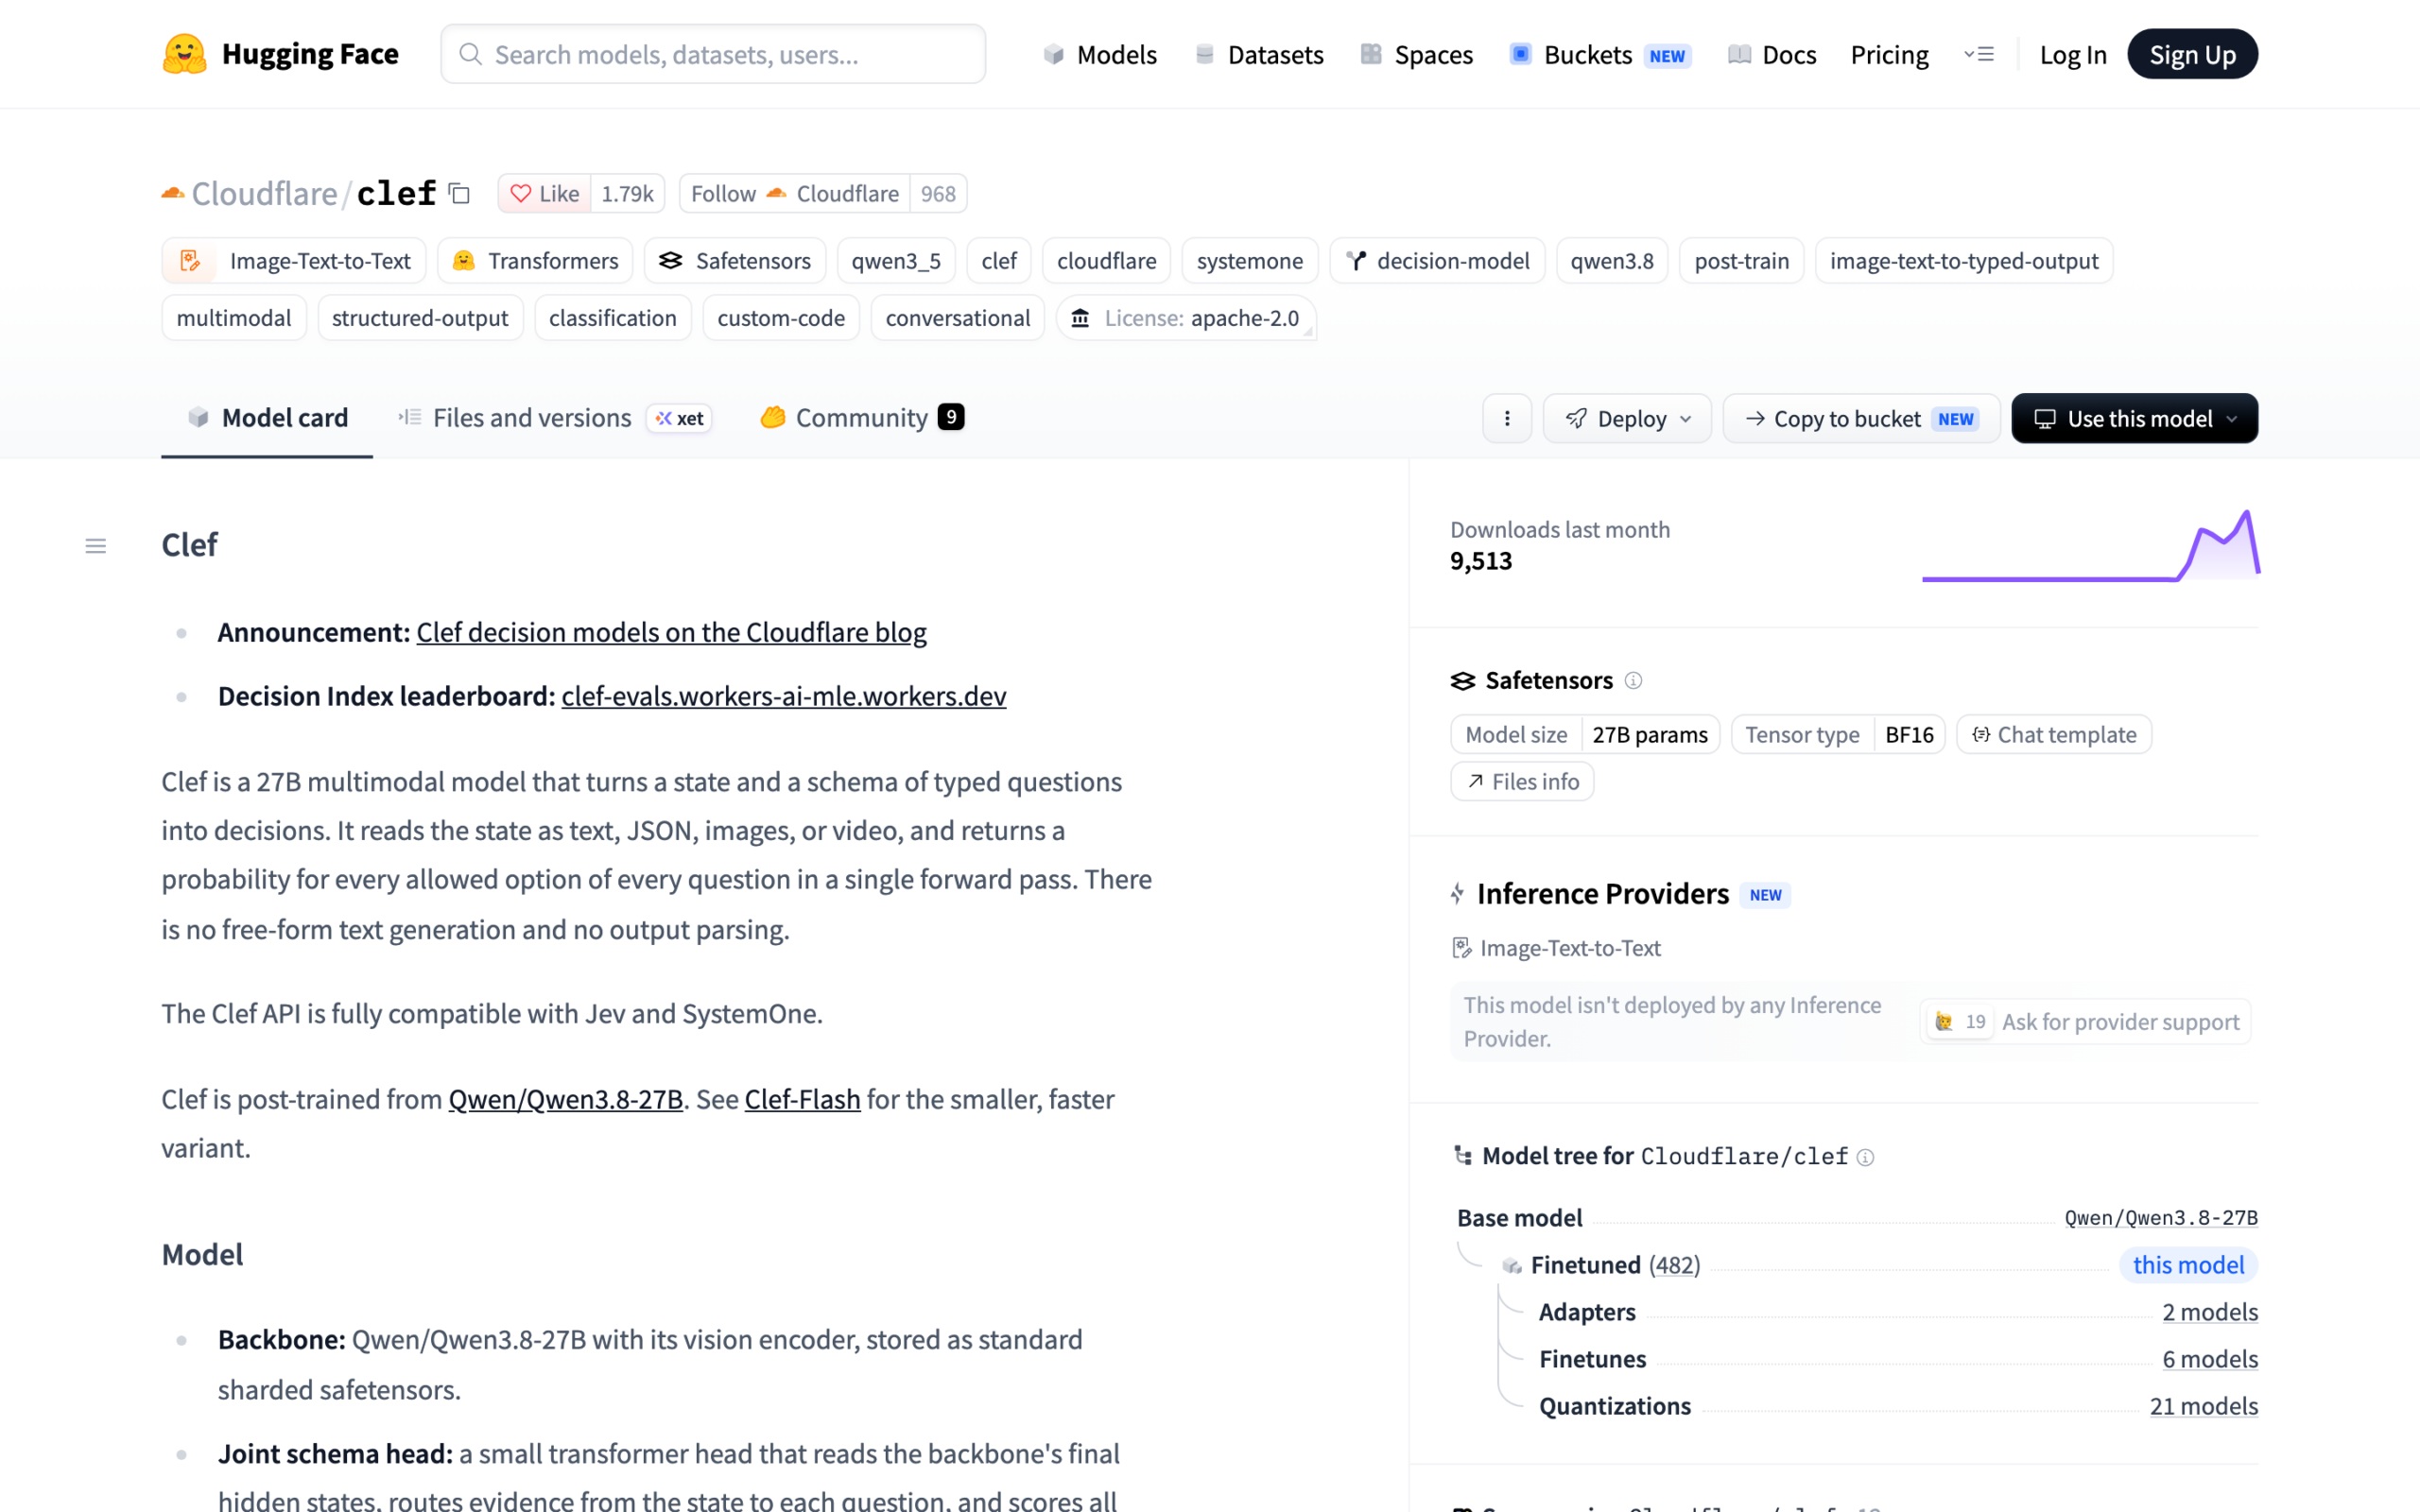
모델 카드의 설명을 보면 핵심이 뚜렷합니다. 백본 트랜스포머의 최종 은닉 상태(Hidden States) 뒤에 붙은 조인트 스키마 헤드가 요청된 모든 질문을 동시에 읽고, 허용된 선택지들의 확률을 단 한 번의 연산으로 병렬 출력합니다. – 자유 텍스트 생성 없음 (No free-form text generation): 토큰 루프를 돌지 않으므로 생성 지연이 없습니다. – 출력 파싱 없음 (No output parsing): 스키마가 모델 연산 자체에 내장되어 있어 구조적 타입 안전성을 가집니다. – 출력 토큰 비용 0원 (Output tokens: FREE): 추가 토큰 생성이 전혀 일어나지 않으므로 출력 비용이 들지 않습니다.
기존 생성형 LLM (Autoregressive)
- 토큰을 하나씩 순차적으로 생성 (3~30초 이상 소요)
- 소프트웨어에서 쓰려면 JSON 파싱과 유효성 검증 필수
- 비싼 출력 토큰당 과금 (입력 토큰의 약 5배)
- 환각이나 스키마 이탈 위험 상존
의사결정 모델 (System One / Single Forward Pass)
- 단 한 번의 순전파로 모든 질문을 병렬 평가 (38~200ms)
- 구조적 타입 안전성 확보 (파싱 불필요)
- 출력 토큰 완전 무료 (FREE), 극단적으로 저렴한 입력 단가
- 잘 보정된 확률(Calibrated Probability)과 신뢰도 반환
3사가 공개한 실제 수치와 벤치마크
2026년 가을에 연이어 공개된 3사 제품의 구체적인 제원과 가격 체계입니다.
| 제품 | 공개일과 상태 | 백본 및 크기 | 과금 체계 | 중앙 지연 시간 |
|---|---|---|---|---|
| TypeSafe Jev | 2026년 9월 15일, 얼리 액세스 | 독자 아키텍처 | 입력 토큰당 $0.042 / MTok (10억 토큰당 $42), 출력 무료 | 70 ~ 500ms |
| Cloudflare Clef / Clef-flash | 2026년 10월 1일, Workers AI 및 Apache 2.0 | Qwen 27B / 9B | Workers AI 종량 과금, 오픈소스 모델은 무료 셀프 호스팅 | 38.8ms (flash) / 209.3ms (Clef) |
| OpenAI Decisions API | 2026년 10월 6일, 공개 베타 | gpt-6-luna |
입력 토큰에만 과금 (Responses API 대비 약 10배 속도) | 미공개 (Responses 대비 10배) |
TypeSafe는 Jev가 자체 평가에서 기존 LLM 대비 최대 193.6배 빠르고 444.6배 저렴했다고 밝혔습니다. 제번스의 역설에서 따온 이름처럼, 추론 단가를 극적으로 낮춰 수많은 소프트웨어 내부에 결정 엔진을 심겠다는 포부입니다.
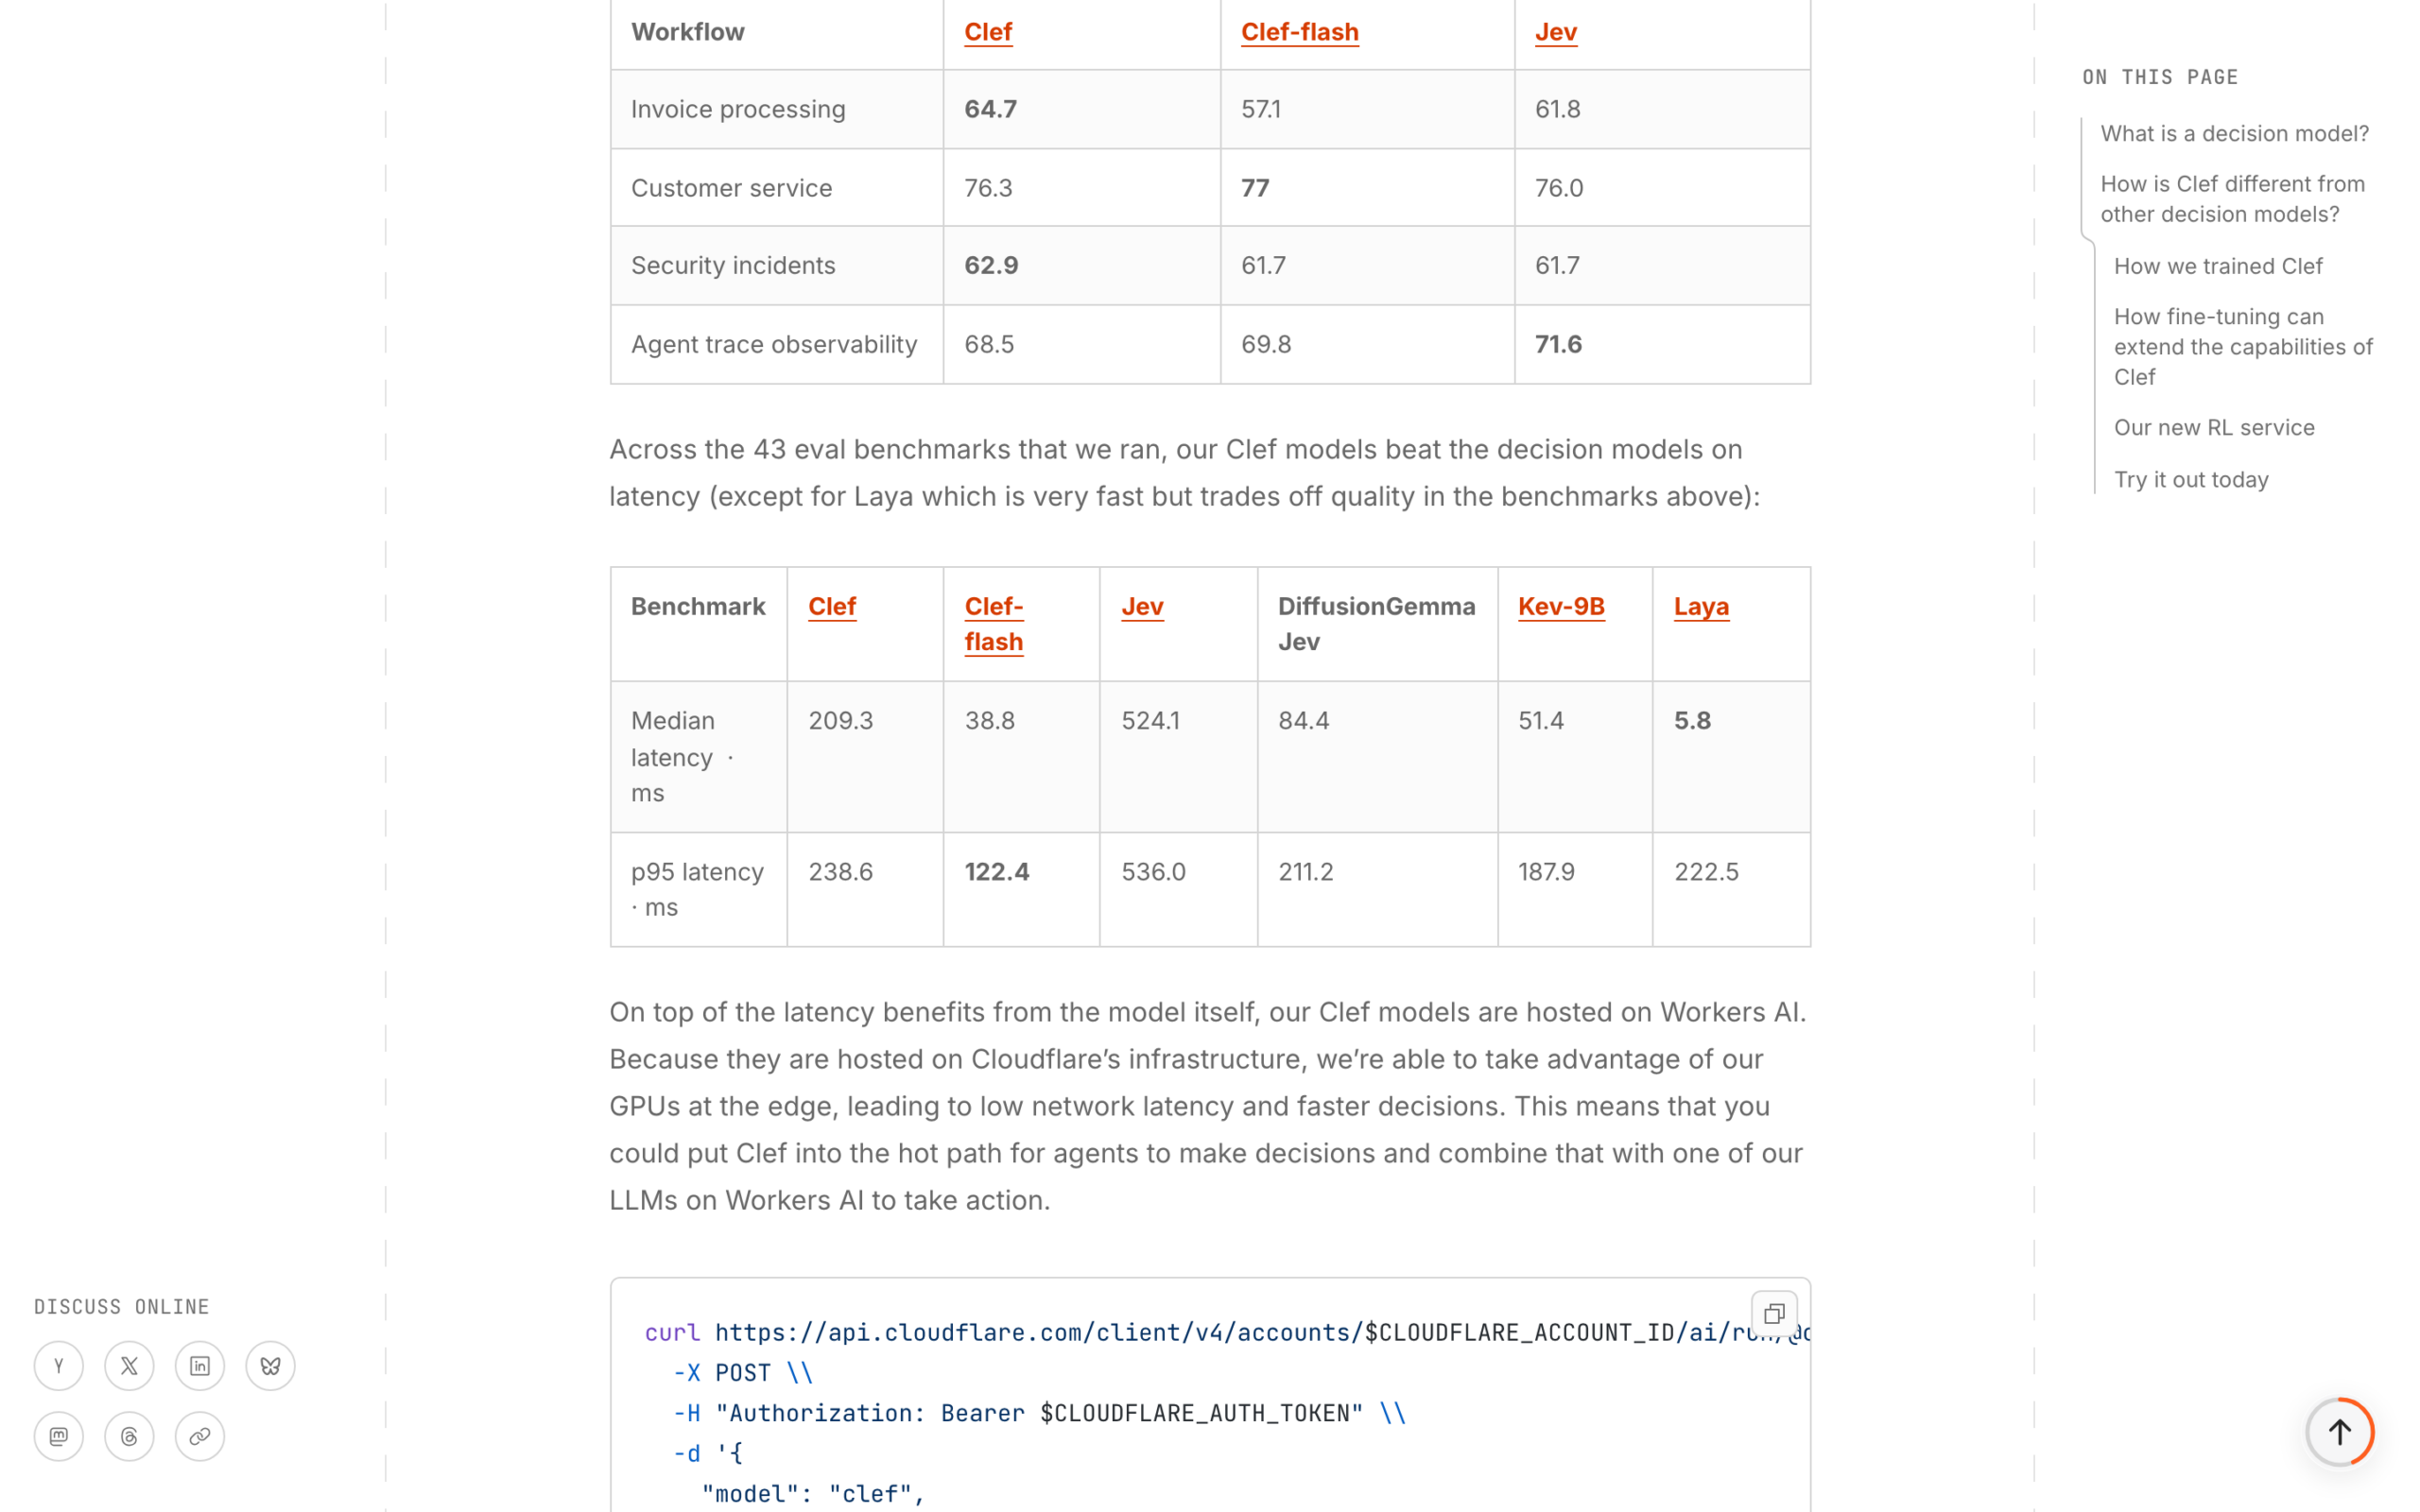
Cloudflare가 43개 평가 벤치마크를 돌려 직접 비교한 결과는 더욱 구체적입니다. – 지연 시간 중앙값(Median Latency): Clef-flash 38.8ms, Clef 209.3ms, Jev 524.1ms – p95 지연 시간: Clef-flash 122.4ms, Clef 238.6ms, Jev 536.0ms – 함수 호출 리더보드(BFCL): Clef-flash 98.76%, Clef 98.47%, Jev 95.75% – 실제 업무 워크플로 정확도: 고객 지원(Customer Service) 77.0%, 보안 사고 분석(Security Incidents) 62.9%
Clef-flash는 40밀리초 미만의 속도로 응답하므로, 사용자가 엔터를 치는 순간 실시간 라우팅이나 즉각적인 필터링을 체감 지연 없이 수행할 수 있습니다.
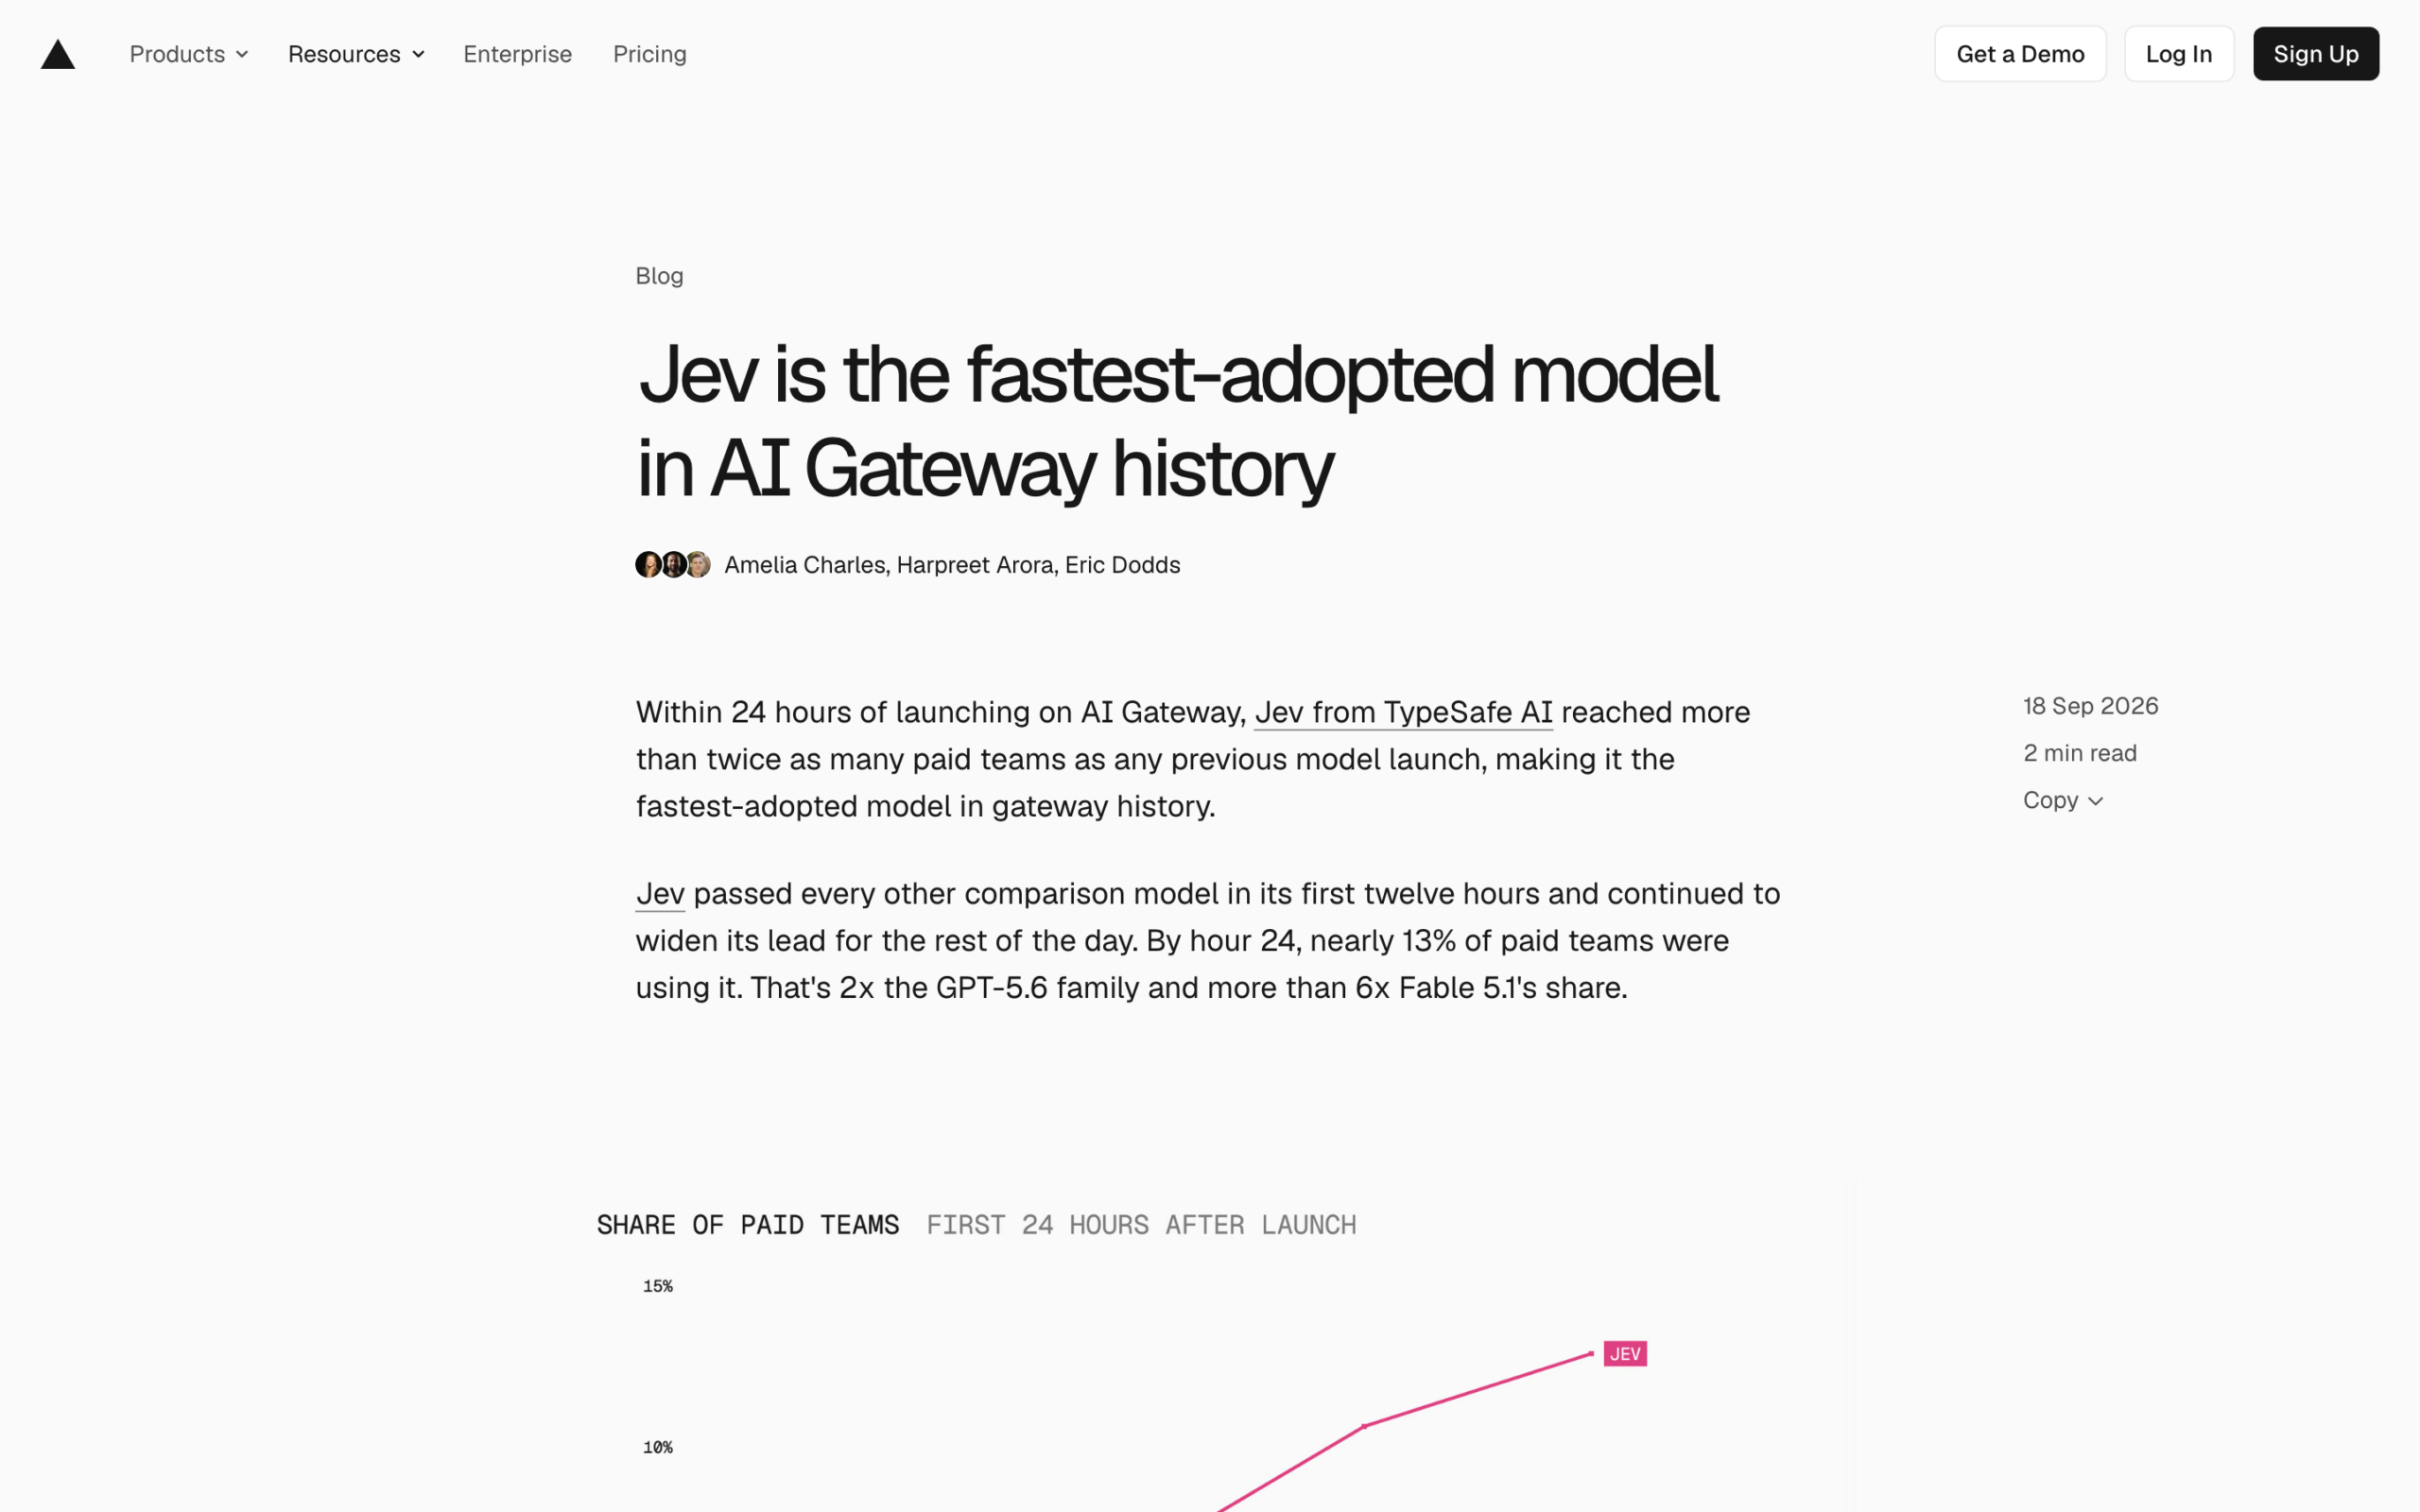
실제 개발자 생태계의 반응도 뜨겁습니다. Vercel의 공식 발표에 따르면 AI Gateway에 Jev가 론칭된 지 24시간 만에 유료 팀의 13% 가까이가 Jev를 프로덕션에 붙였습니다. 이는 GPT-5.6이나 Fable 5.1 같은 대형 모델의 첫날 채택률을 두 배 이상 앞선 수치입니다.
RAG – 원리와 쓰지 않아도 되는 경우구조화 출력·함수 호출과 갈리는 지점
JSON 스키마에 맞춰 답을 받는 구조화 출력(Structured Outputs)이 이미 있는데 의사결정 모델은 무엇이 다를까요? OpenAI 공식 가이드는 그 용도를 명확히 선을 그어 둡니다.
- 의사결정 모델(Decisions): 참일 확률, 고정된 선택지 중 하나, 기준표에 따른 점수가 필요할 때 사용합니다.
- 구조화 출력(Structured Outputs): 본문 요약, 데이터 추출처럼 내 스키마를 따르는 새로운 텍스트 객체를 생성해야 할 때 씁니다.
- 함수 호출(Function Calling): 모델이 인자를 조합해 외부 도구를 실행하도록 요청해야 할 때 씁니다.
예전부터 있던 전통적인 머신러닝 분류기(Classifier)와의 차이도 뚜렷합니다. 분류기는 새 카테고리를 넣으려면 데이터를 모아 다시 학습시켜야 했지만, 의사결정 모델은 재학습 없이도 임의의 자연어 지시문과 선택지를 즉시 넣을 수 있습니다. 오토 모드 글에서 살펴본 보안 분류기도 이러한 판정 장치의 일종이었습니다.
주의할 점도 있습니다. 의사결정 모델은 긴 글을 쓰거나 코드를 작성하지 못합니다. 코딩 에이전트의 메인 브레인을 대체할 수는 없으며, 에이전트 파이프라인 내부에서 ‘도구 선택’, ‘가드레일 검사’, ‘작업 지속 여부 판정’을 내리는 초고속 관제탑 역할에 적합합니다.
공식 자료가 든 의사결정 모델의 구체적 쓰임새
각 회사 문서와 개발자 가이드에 소개된 대표적인 활용 분야입니다.
-
에이전트 도구 및 라우팅 제어: 사용자의 지시를 분석해 수십 개의 도구 중 어떤 것을 실행할지 고르거나, 서브에이전트에게 일을 넘길지 결정합니다.
-
실시간 가드레일 및 탈옥 탐지: LLM에 프롬프트가 입력되기 전 악의적인 주입 공격인지 38ms 만에 판정하여 차단합니다.
-
스마트 RAG 리랭킹: 검색해 온 수십 개의 문서 조각마다 질문과의 관련성 점수(
score)를 매겨 필요한 것만 추립니다. 자세한 검색 원리는 RAG 글에 다루었습니다. -
고객 문의 자동 분류 및 에스컬레이션: 인입된 문의의 긴급도와 담당 부서를 즉시 판정해 담당 팀 슬랙으로 토스합니다.
-
이미지 기반 불량 검수: 제품 사진을 받아 눈에 띄는 흠집이나 파손이 있는지 참·거짓(
predicate)으로 검사합니다.
이러한 제어 구조는 모델을 둘러싼 보호벽을 설계하는 AI 하네스 기법과 직결됩니다.
질문 설계의 기본 원칙
TypeSafe 문서는 복잡한 문제를 한 질문에 뭉뚱그리지 말고 잘게 쪼개라고 권장합니다. 예컨대 “이 투자 제안서를 평가해 줘”라고 묻는 대신, 기술 실현성, 시장성, 팀 역량을 각각 별도 질문으로 묻고 점수는 코드에서 가중치 공식으로 합산하는 것이 정확도를 극대화하는 비결입니다.
지금 쓸 수 있는 개발자 연동 경로와 제약
세 제품 모두 표준 HTTP 호출과 SDK를 지원합니다.
| 플랫폼 | 호출 엔드포인트 및 SDK | 주요 특징 |
|---|---|---|
| TypeSafe | POST /v1/systemone, Python & JS SDK, Playground |
요청당 최대 64k 토큰, 얼리 액세스 신청 필요 |
| Vercel AI Gateway | typesafe-ai/jev, AI SDK 7의 evaluate 함수 |
AI SDK 7.0.105 이상, 별도 가입 없이 즉시 연동 |
| Cloudflare Workers AI | @cf/cloudflare/clef, @cf/cloudflare/clef-flash |
요청당 질문 최대 64개, 이미지 최대 4장, 엣지 서빙 |
| Hugging Face | Cloudflare/clef 가중치 다운로드 |
Apache 2.0 라이선스, H200 등 로컬 GPU 서빙 |
| OpenAI | POST /v1/decisions, 공식 SDK, Playground |
공개 베타, 모델 gpt-6-luna, base64 이미지 지원 |
Cloudflare Workers 코드에서는 단 몇 줄로 의사결정 모델을 실행할 수 있습니다.
export default {
  async fetch(request, env) {
    const decision = await env.AI.run('@cf/cloudflare/clef-flash', {
      state: "결제 과정에서 잔액 부족 오류가 발생했습니다.",
      questions: [
        {
          type: "choice",
          name: "category",
          choices: [
            { value: "billing", description: "결제 및 환불 관련" },
            { value: "account", description: "계정 및 로그인 관련" }
          ]
        }
      ]
    });
    return Response.json(decision);
  }
};
도입 전 알아둘 한계 (Jaggedness)
TypeSafe 문서는 jev-1.13 모델이 유독 취약한 작업들을 솔직하게 공개했습니다(2026년 10월 기준).
– 단순 개수 세기와 수학 계산: “단어가 몇 개인가”, “금액 합산” 등은 모델에 맡기지 말고 정규식이나 코드로 처리해야 합니다.
– 날짜 전후 비교: 시점 비교 역시 파이썬의 datetime 로직에 맡기는 편이 안전합니다.
– 장황한 무관 텍스트: 수만 자의 노이즈가 섞이면 판단 정확도가 떨어지므로, 상태에 필요한 핵심 문맥만 정제해 보내는 컨텍스트 관리가 필요합니다.
– 다국어 정확도 차이: 학습 데이터의 중심이 영어이므로 한글 데이터를 넣을 때는 신뢰도 임계값(Threshold)을 사전에 테스트해 보아야 합니다.
참고한 공식 문서
이 글은 TypeSafe 공식 발표와 문서, Cloudflare Clef 발표와 Workers AI 문서, Clef 모델 카드, OpenAI Decisions 가이드, Vercel 공식 출시 공지를 바탕으로 정리했습니다.
의사결정 모델 자주 묻는 질문
의사결정 모델이 뭔가요?
문장을 순차적으로 생성하지 않고, 미리 정한 질문에 대해 타입이 정해진 답과 보정된 확률을 돌려주는 모델입니다. TypeSafe 문서는 소프트웨어가 바로 쓸 수 있는 빠르고 구조화된 결정을 내리도록 만든 모델이라고 설명하고, 질문 유형은 선택, 점수, 참·거짓 세 가지입니다.
기존 LLM보다 왜 수십 배 빠르고 출력 비용이 무료인가요?
기존 LLM은 단어를 한 토큰씩 차례로 예측하는 자기회귀(Autoregressive) 방식을 써서 수 초 이상 걸립니다. 반면 의사결정 모델은 백본의 최종 상태에서 결합된 스키마 헤드를 통해 단 한 번의 순전파(Single Forward Pass)로 모든 질문의 확률을 병렬 추출하므로 수십 밀리초(38ms~200ms) 만에 끝나고 출력 토큰 비용이 발생하지 않습니다.
구조화 출력이나 함수 호출과는 어떻게 나눠 쓰나요?
OpenAI 문서 기준으로, 참일 확률·고정된 선택지 중 하나·기준표에 따른 점수가 필요하면 Decisions API를 쓰고, 추출한 필드나 설명 글처럼 내 JSON 스키마를 따르는 객체를 생성해야 하면 Responses API의 구조화 출력을, 인자가 붙은 도구 호출이 필요하면 함수 호출을 씁니다.
한국어 내용에도 쓸 수 있나요?
Jev의 모델 문서는 영어가 주된 학습 언어이고 정확도도 영어에서 가장 좋다고 적고 있습니다. 한중일 문자를 포함한 다른 언어도 처리하지만 같은 수준은 아니어서, 영어가 아닌 작업에 쓰기 전에 자체 콘텐츠로 시험해 보라는 안내가 함께 있습니다.
글에 나온 규칙 파일과 에이전트는 Claude Code에서 쓰는 방식이고, 공식 안내는 Claude Code 공식 문서에 있습니다.
이 글은 직접 만들고 운영하며 남긴 기록입니다. 적힌 수치는 작성 시점의 제 계정 기준이며, 같은 결과나 수익을 보장하지 않습니다.
2 Comments