서브에이전트 – 역할을 나눠 검증하는 방법
서브에이전트는 특정 종류의 일을 맡는 보조 AI 에이전트입니다. 메인 대화와 분리된 컨텍스트 창에서 전용 지시문과 정해진 도구만 가지고 일한 다음, 결과를 메인 대화로 돌려줍니다.
이 글의 앞쪽은 Claude Code 공식 문서를 기준으로 서브에이전트의 정의와 설정 파일 형식을 정리한 내용이에요. 뒤쪽에는 Anthropic이 공개한 리서치 시스템 사례와, 제가 앱인토스 미니앱을 만들 때 쓰는 검증 에이전트 구성을 실었습니다.
서브에이전트란 무엇인가
Claude Code 공식 문서의 공식 안내는 서브에이전트를 특정 유형의 작업을 처리하는 전문 AI 어시스턴트라고 정의합니다. 각 보조 에이전트는 자기 컨텍스트 창에서 돌아가고, 따로 쓴 시스템 프롬프트와 지정된 도구 접근 권한, 독립된 권한 설정을 가집니다.
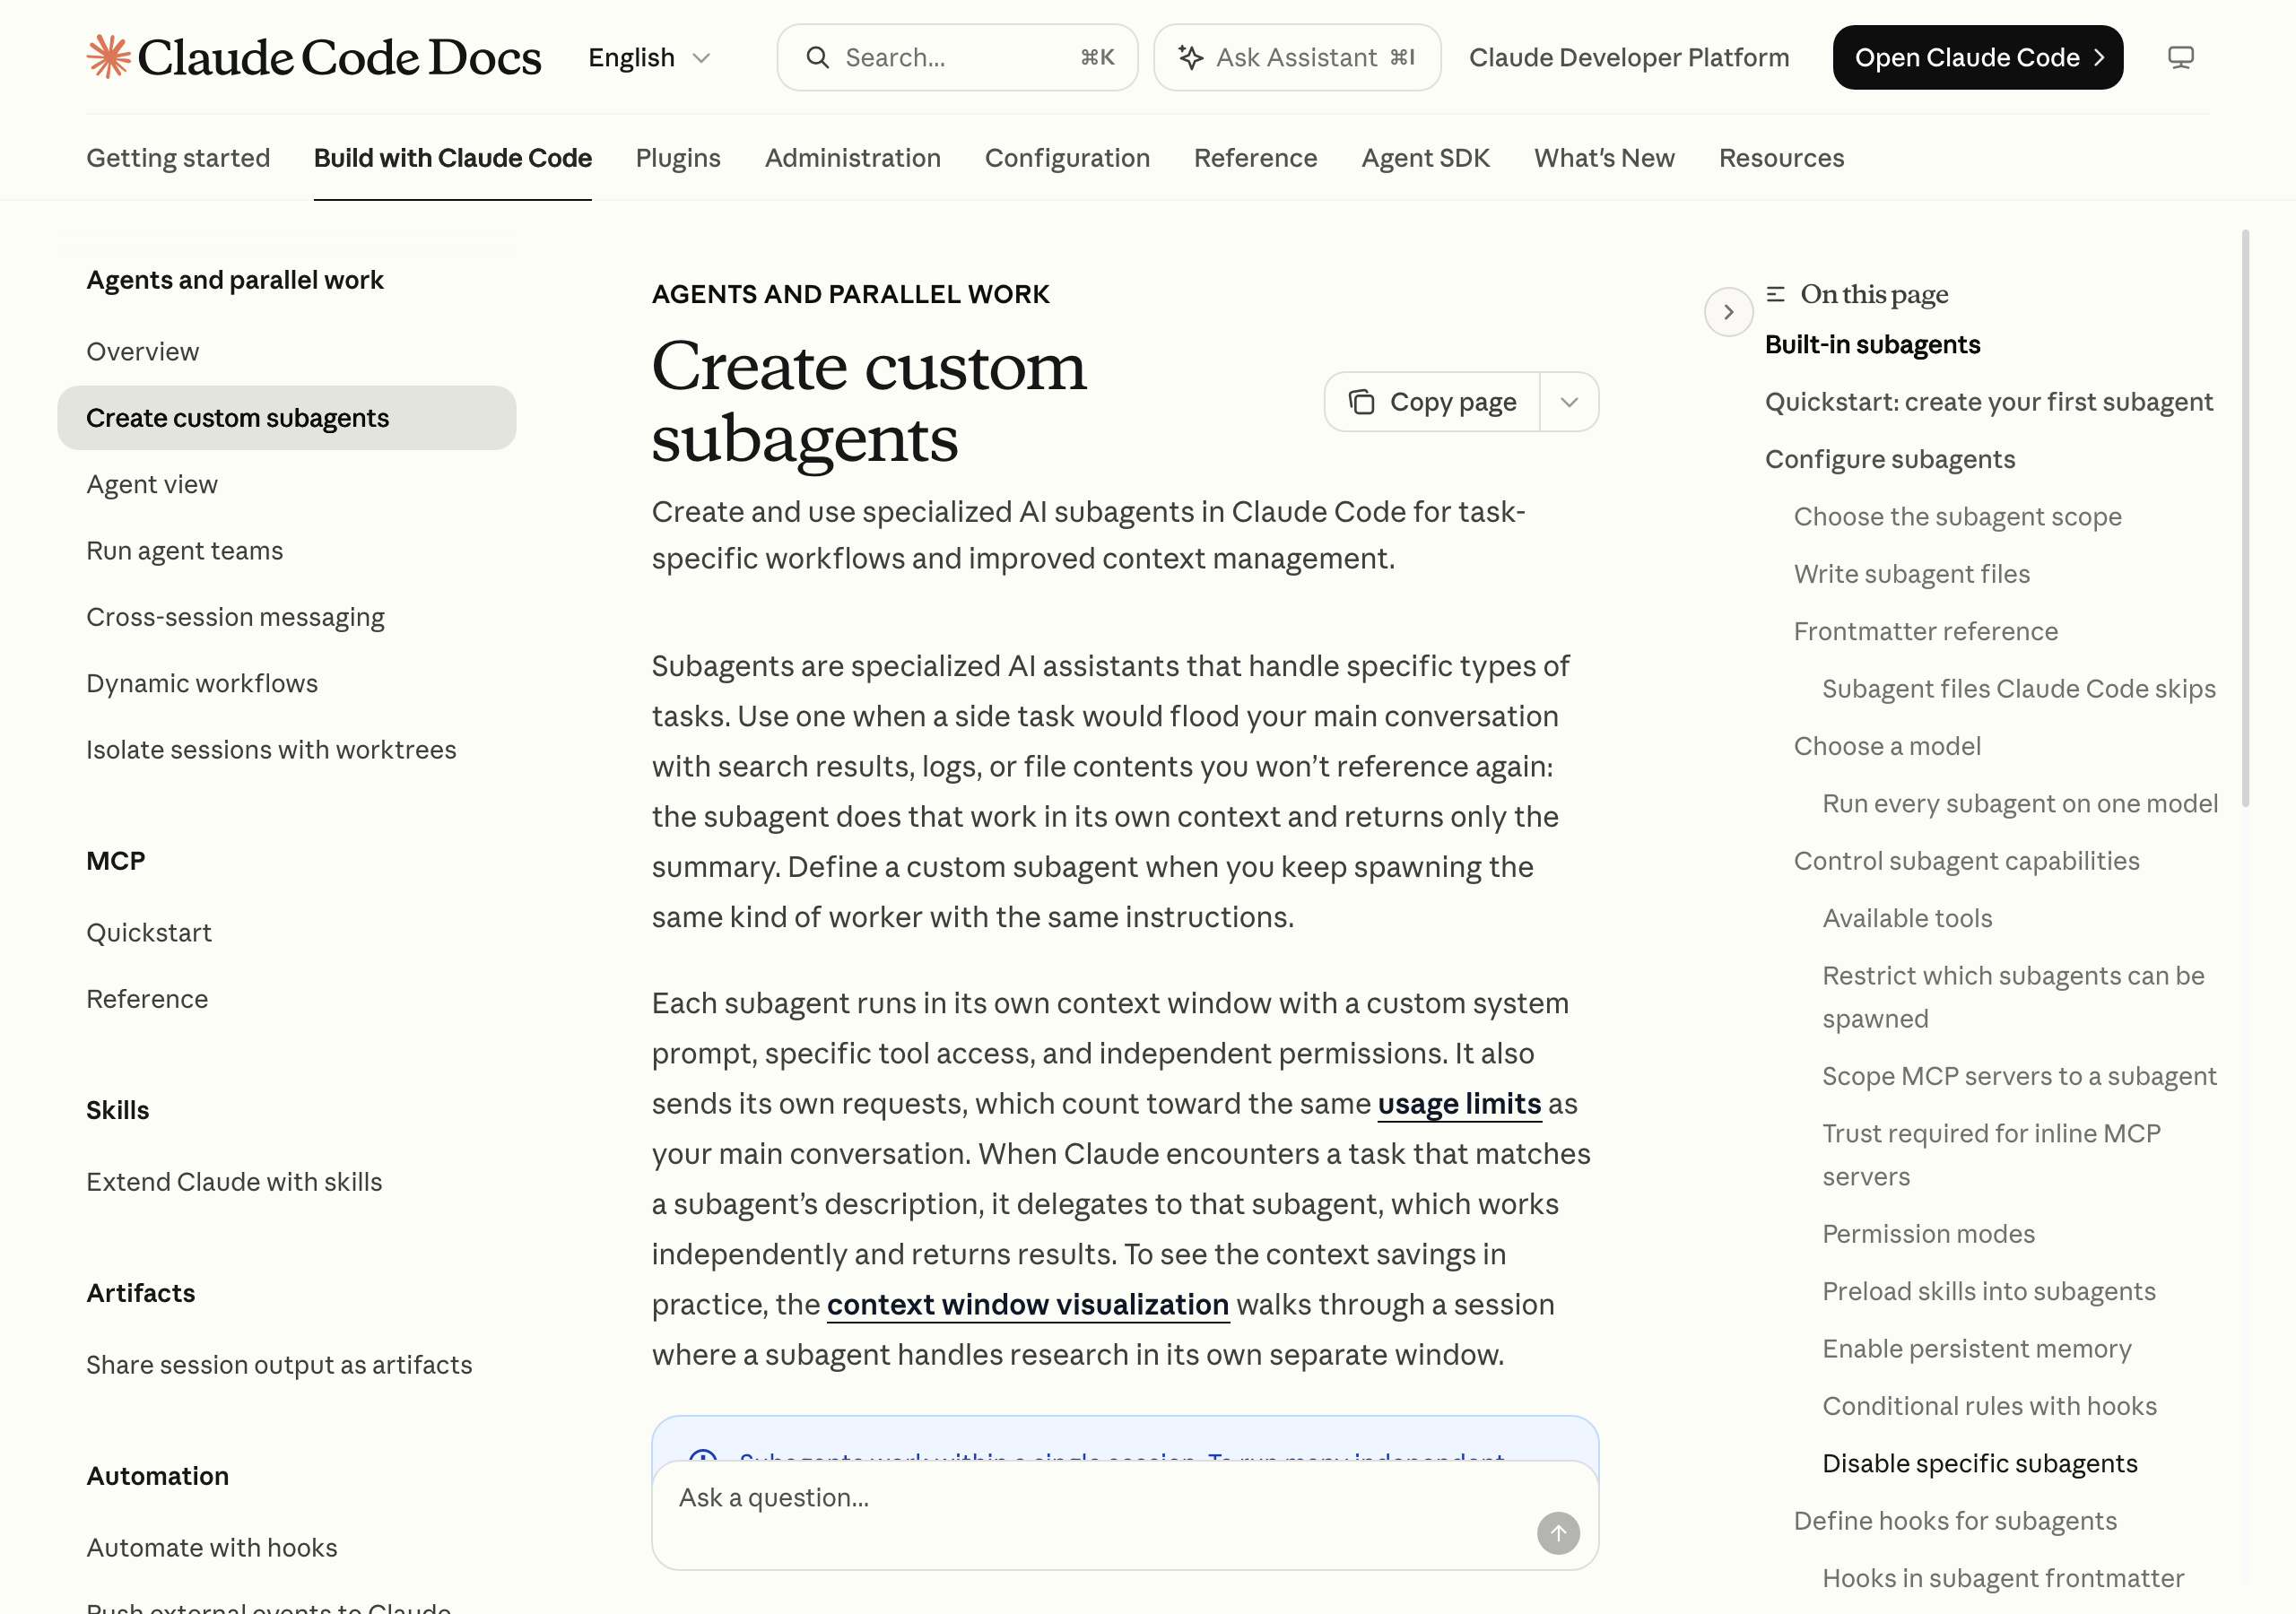
동작 순서는 이렇습니다. Claude가 일을 하다가 어떤 서브에이전트의 설명과 맞는 작업을 만나면 그 보조 에이전트에게 넘기고, 보조 에이전트는 독립적으로 일한 뒤 결과를 돌려줍니다. 문서에 따르면 보조 에이전트는 새 컨텍스트 창에서 시작해서 지금까지의 대화 기록이나 Claude가 이미 읽은 파일을 보지 못해요. Claude가 넘기면서 써 주는 위임 메시지가 출발점입니다. 대화를 그대로 이어받는 포크 방식은 여기서 예외로 적혀 있습니다.
서브에이전트 하나를 이루는 것을 정의 파일의 항목과 맞춰 보면 아래와 같습니다.
| 구성 | 뜻 | 정의 파일에서는 |
|---|---|---|
| 별도 컨텍스트 | 메인 대화와 분리된 컨텍스트 창 | 따로 적지 않아도 기본 동작 |
| 전용 지시문 | 이 에이전트만 받는 시스템 프롬프트 | 파일의 본문 |
| 허용 도구 | 쓸 수 있는 도구의 목록 | tools |
| 모델 | 이 에이전트가 쓸 모델 | model |
| 맡길 조건 | Claude가 위임할지 판단하는 근거 | description |
공식 문서가 말하는 나눠 쓰는 이유
문서는 보조 에이전트가 도움이 되는 지점을 이렇게 꼽습니다.
- 탐색과 구현 과정을 메인 대화 밖에 둬서 컨텍스트를 아낀다
- 쓸 수 있는 도구를 제한해서 제약을 강제한다
- 사용자 수준 서브에이전트로 여러 프로젝트에서 설정을 다시 쓴다
- 분야에 맞춘 시스템 프롬프트로 동작을 특화한다
- 더 빠르고 저렴한 모델로 일을 보내 비용을 조절한다
그렇다고 모든 일을 넘기라는 얘기는 아니에요. 같은 문서에 메인 대화에 남길 일과 보조 에이전트에 맡길 일을 가르는 기준이 있는데, 그중 몇 가지를 옮기면 이렇습니다.
메인 대화가 맞는 일
- 자주 주고받으며 다듬어야 한다
- 계획, 구현, 테스트가 같은 컨텍스트를 많이 공유한다
- 빠르게 끝나는 작은 수정
서브에이전트가 맞는 일
- 메인 대화에 남길 필요 없는 긴 출력이 나온다
- 도구나 권한을 제한하고 싶다
- 혼자 끝낼 수 있고 요약으로 돌려줄 수 있다
사용량도 문서에 적혀 있습니다. 보조 에이전트는 자기 요청을 따로 보내고 그 요청은 메인 대화와 같은 사용 한도에 합산돼요.
AI 적용 사례 – Anthropic의 멀티 에이전트 리서치 시스템서브에이전트 설정 파일은 마크다운 한 장
보조 에이전트는 YAML frontmatter가 붙은 마크다운 파일로 정의합니다. 프로젝트의 .claude/agents/ 폴더에 두면 그 프로젝트에서, 홈 폴더의 ~/.claude/agents/에 두면 내 모든 프로젝트에서 쓸 수 있습니다.
아래는 제 프로젝트에 있는 정의 파일 하나의 맨 윗부분입니다.
---
name: ait-engine-verifier
description: 판정·계산 엔진을 조합 전수로 검증한다. 계획서의 판정 규칙이나 계산식을 구현한 뒤, 화면을 만들기 전에 쓴다. 빈 결과, 모순, 경계값, 분포 편향을 실제로 실행해서 잡아낸다.
model: opus
tools: Read, Write, Edit, Bash, Grep, Glob
---
공식 문서 기준으로 필수 항목은 name과 description 둘입니다. tools를 생략하면 서브에이전트가 쓸 수 있는 도구를 모두 물려받고, model에는 sonnet, opus, haiku 같은 별칭이나 전체 모델 ID, 메인 대화와 같은 모델을 뜻하는 inherit를 적을 수 있어요. frontmatter 아래의 본문은 그 보조 에이전트의 시스템 프롬프트가 됩니다.
description은 짧게, 자세한 내용은 본문에
Claude는 description을 보고 일을 넘길지 정합니다. 문서는 이 설명들이 컨텍스트를 차지하니 짧게 쓰고, 자세한 내용은 본문으로 옮기라고 안내해요. 본문은 그 서브에이전트가 실제로 돌 때만 읽힙니다.
Anthropic의 멀티 에이전트 리서치 시스템
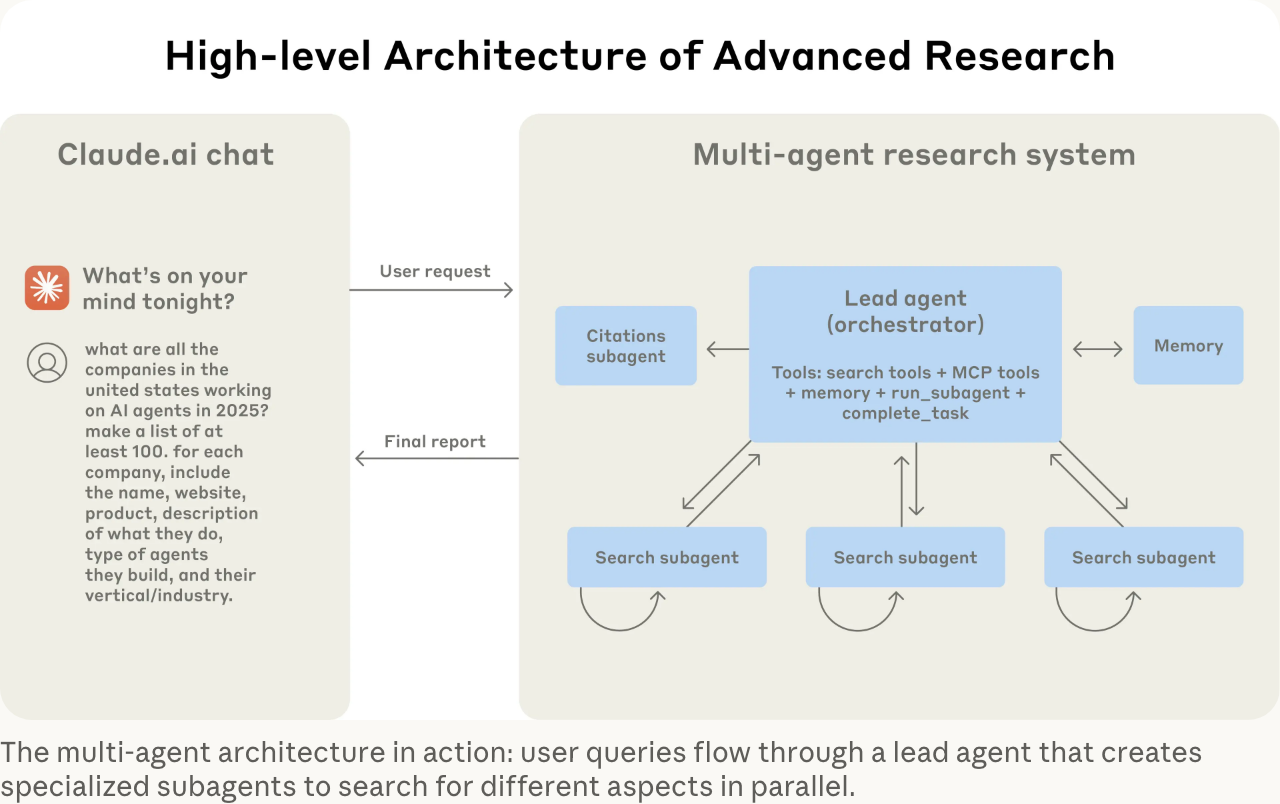
보조 에이전트를 크게 쓴 사례로는 Anthropic이 2025년 6월 13일 엔지니어링 블로그에 공개한 멀티 에이전트 리서치 시스템 글이 있습니다. Claude의 리서치 기능을 어떻게 만들었는지 설명한 글이에요.
구조는 리드 에이전트 하나가 전체를 조율하는 방식입니다. 사용자가 질문을 넣으면 리드 에이전트가 질문을 분석해 전략을 세우고, 질문의 서로 다른 측면을 동시에 탐색할 서브에이전트를 만듭니다. 보조 에이전트들은 각자 검색하고 찾은 내용을 리드 에이전트에게 돌려줘요. 리드 에이전트는 결과를 종합해서 조사가 더 필요한지 판단하고, 충분해지면 출처를 붙이는 별도 에이전트를 거쳐 답을 내놓습니다.
글에 적힌 수치는 조건과 함께 봐야 합니다.
같은 글은 한계도 분명히 적었습니다. 토큰을 빠르게 쓰는 구조라서 그 비용을 감당할 만큼 가치가 큰 작업이어야 하고, 모든 에이전트가 같은 컨텍스트를 공유해야 하거나 에이전트 사이의 의존이 많은 영역에는 지금은 잘 맞지 않는다고 해요. 대부분의 코딩 작업은 리서치보다 병렬로 쪼갤 수 있는 부분이 적다는 언급도 있습니다.
일을 넘기는 방법에 대한 대목도 있습니다. 보조 에이전트에게는 목표, 출력 형식, 쓸 도구와 자료에 대한 안내, 분명한 작업 경계가 필요하고, 설명이 자세하지 않으면 에이전트들이 같은 일을 중복하거나 빈틈을 남긴다는 내용입니다.
AI 하네스 – 미니앱 제작에 적용한 방법미니앱 제작에 둔 검증 서브에이전트
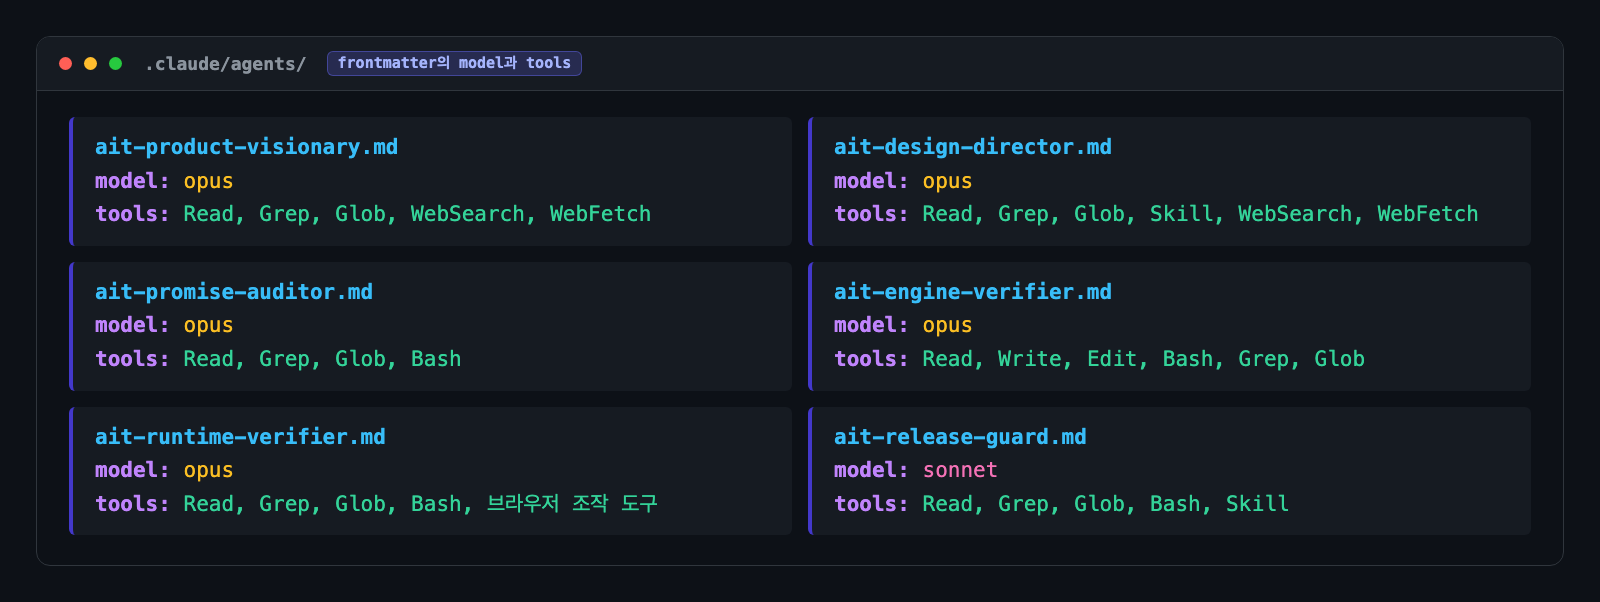
제 프로젝트의 .claude/agents/ 폴더에는 정의 파일이 여섯 개 있습니다. 여섯 모두 무언가를 만드는 쪽이 아니라 검증하거나 감수하는 쪽이에요.
| 에이전트 | 확인하는 것 | 허용 도구 |
|---|---|---|
ait-product-visionary |
기획안이 무엇을 만들고 무엇을 뺄지 | Read, Grep, Glob, WebSearch, WebFetch |
ait-design-director |
계획서의 화면 설계 | Read, Grep, Glob, Skill, WebSearch, WebFetch |
ait-promise-auditor |
이름·설명이 약속한 것이 화면에 있는지 | Read, Grep, Glob, Bash |
ait-engine-verifier |
판정·계산 엔진을 조합 전수로 실행 | Read, Write, Edit, Bash, Grep, Glob |
ait-runtime-verifier |
빌드된 앱을 띄워 브라우저로 구동 | Read, Grep, Glob, Bash, 브라우저 조작 도구 |
ait-release-guard |
광고 배치·문구, 자동 팝업, 푸시 규칙, 레이아웃 | Read, Grep, Glob, Bash, Skill |
model은 ait-release-guard만 sonnet이고 나머지 다섯은 opus입니다. 도구 목록에 Write와 Edit가 들어 있는 건 ait-engine-verifier 하나인데, 이 에이전트의 본문에는 검증 스크립트를 직접 써서 Node로 실행하라는 절차가 적혀 있어요.
언제 누구를 부르는지는 규칙 파일에 정해 뒀습니다.
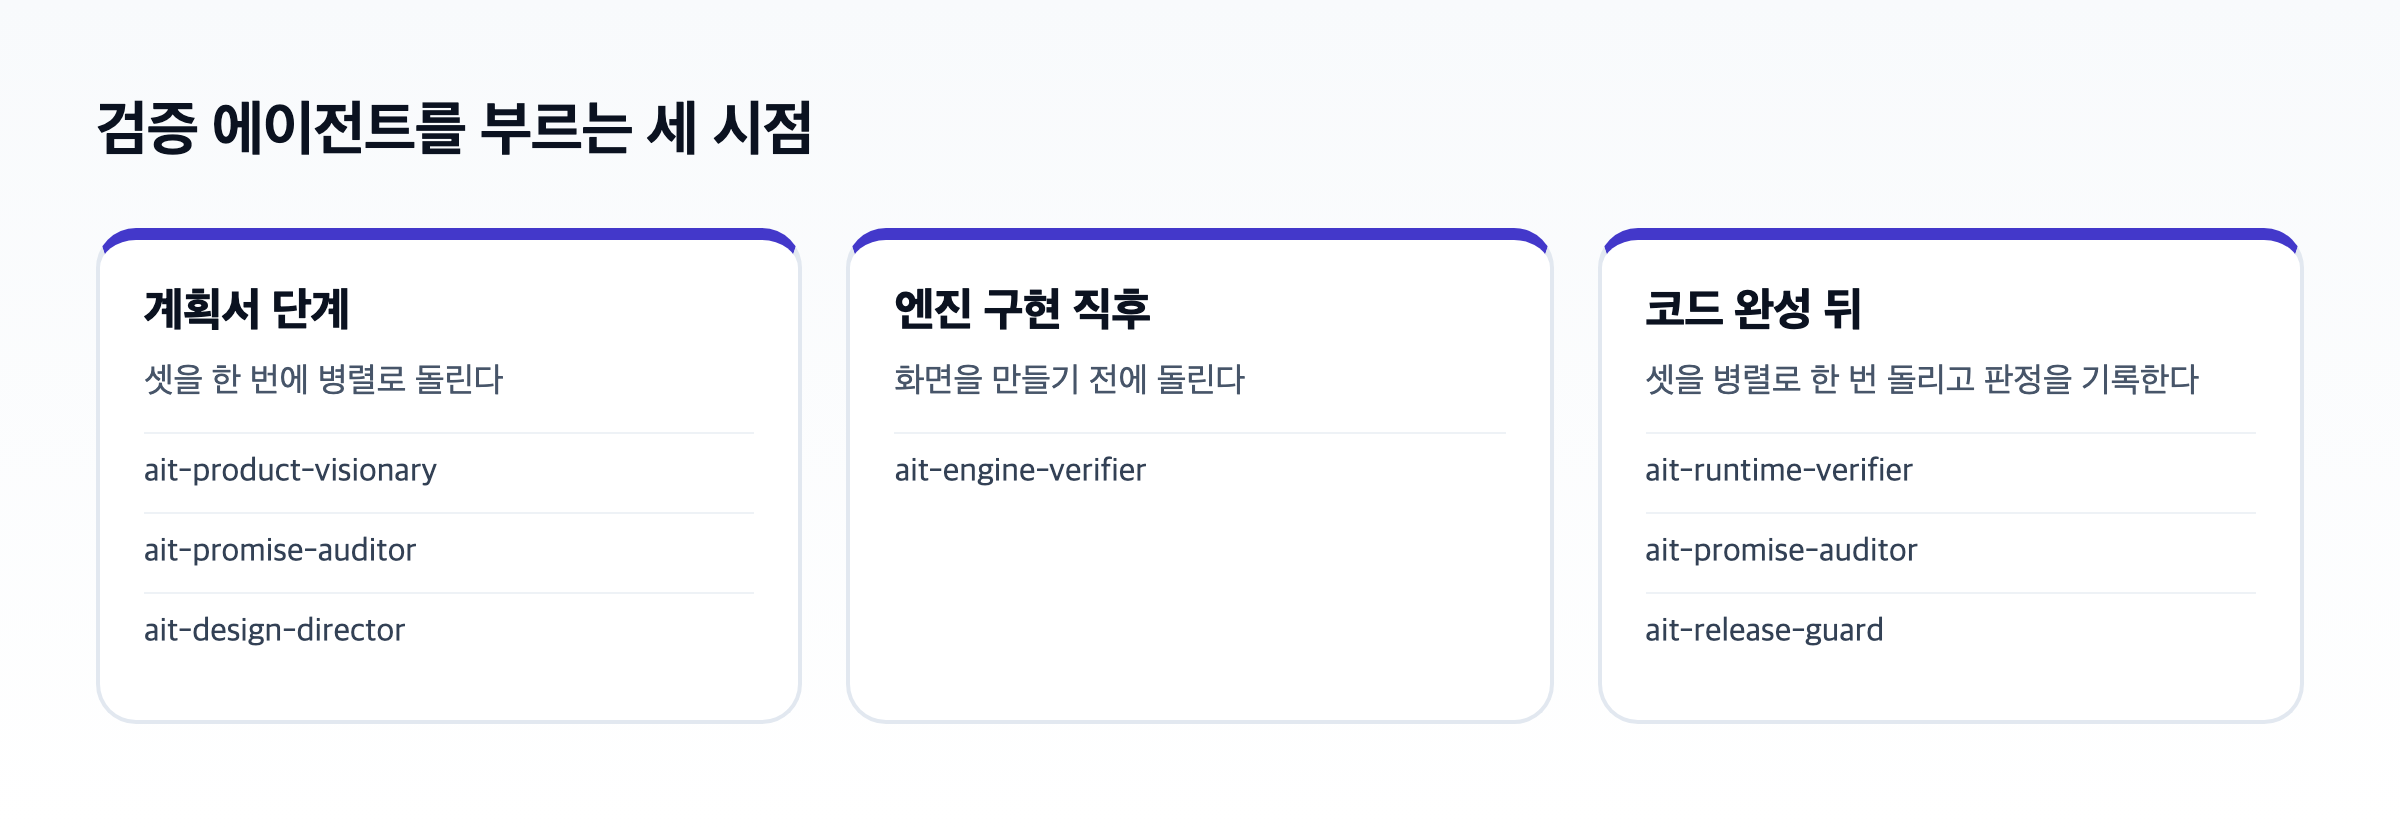
계획서 단계에서는 셋을 한 번에 병렬로 돌리고, 지적이 서로 충돌하면 판단을 적습니다. 제작 단계에서는 판정이나 계산 엔진을 구현한 직후, 화면을 만들기 전에 ait-engine-verifier를 먼저 돌려요. 코드를 완성하고 점검 스크립트의 점수 기준을 넘긴 뒤에 나머지 셋을 병렬로 한 번 돌립니다. ait-promise-auditor는 계획서 단계와 제출 전, 두 번 등장합니다.
지시문에 역할의 경계를 적는다
정의 파일의 본문에는 그 에이전트가 무엇을 보는지가 적혀 있고, 기획 단계의 세 파일에는 무엇을 보지 않는지도 적혀 있습니다. 아래는 ait-promise-auditor 본문에서 제목 바로 아래 두 줄이에요.
**앱이 스스로 한 약속을 지키는지**만 본다. 디자인 품질은 `ait-design-director`,
혁신성은 `ait-product-visionary`가 본다.
자기 범위 밖의 일은 어느 에이전트 몫인지 이름으로 가리킵니다. 제가 보기에는 앞에서 본 Anthropic 글의 “분명한 작업 경계”를 정의 파일 안에 미리 적어 둔 셈이에요.
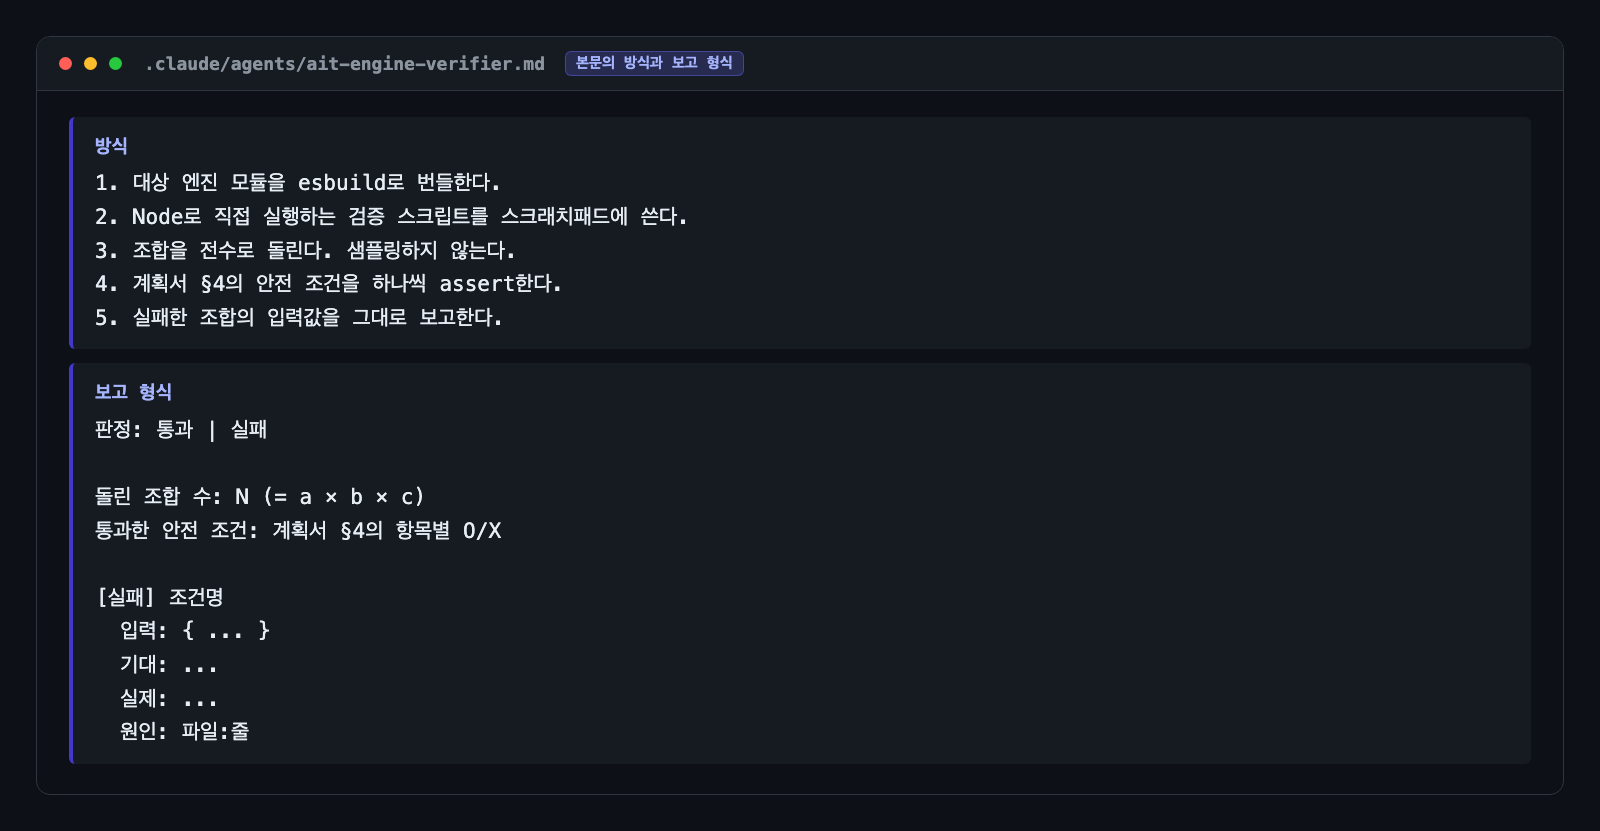
여섯 파일의 본문은 모두 보고 형식을 정해 두고, 첫 줄에 판정을 쓰게 합니다. 그리고 여섯 모두 직접 고치지 말라는 취지의 지시가 들어 있어요. 넷은 보고만 하라고 적었고, 기획 단계의 둘은 고친 계획서를 돌려주지 말라고 적었습니다. ait-engine-verifier 본문의 마지막 두 줄입니다.
**실패를 직접 고치지 않는다.** 재현 입력과 원인 위치만 보고한다.
통과했으면 돌린 조합 수를 반드시 숫자로 적는다 — "검증했다"는 말만으로는 통과가 아니다.
같은 파일에 적힌 검증 방식과 보고 형식을 옮기면 아래와 같습니다. 실행 결과가 아니라 지시문에 적힌 틀이에요.
판정을 기록하고, 다시 돌릴 때는 골라서
출시 전에 도는 셋은 판정을 기록으로 남겨야 합니다. 하네스 스크립트에 그 셋의 이름과 각자 확인할 질문이 상수로 들어 있어요.
const REQUIRED_AUDITS = {
  'ait-promise-auditor': '이름·설명이 약속한 것이 화면에 실체로 있는가',
  'ait-runtime-verifier': '실제로 띄워서 전 화면과 실패 경로가 동작하는가',
  'ait-release-guard': '검수 반려 사유가 남아 있지 않은가',
};
판정을 기록하는 audit 명령은 이 세 이름만 받고, 판정 값은 pass와 fail 둘 중 하나입니다. 이 셋의 기록이 없으면 출시 검사가 막아요. 기록에 소스 지문을 같이 남기고 출시 검사에서 대조하는 부분은 AI 하네스 글에서 코드와 함께 다뤘습니다.
다시 돌리는 규칙도 따로 있습니다. 규칙 파일은 재실행을 비용으로 보고, 알려진 수정을 다 끝낸 뒤에 검증 에이전트를 부르라고 적어 뒀어요. 지적을 고치느라 소스 지문이 달라졌다면 그 지적을 낸 에이전트만 다시 돌리고, 나머지는 범위 밖인 이유를 적어 기록을 넘깁니다.
참고한 공식 자료
Claude Code 서브에이전트 문서와 Anthropic 엔지니어링 블로그의 리서치 시스템 글을 기준으로 썼습니다. 문서의 항목과 기본값은 바뀔 수 있으니 설정하기 전에 원문을 확인하세요.
서브에이전트 자주 묻는 질문
서브에이전트가 뭔가요?
특정 종류의 일을 맡는 전문 AI 어시스턴트입니다. Claude Code 공식 문서 기준으로 자기만의 컨텍스트 창, 전용 시스템 프롬프트, 정해진 도구 접근 권한을 가지고 독립적으로 일한 뒤 결과를 메인 대화로 돌려줍니다.
서브에이전트는 메인 대화 내용을 알고 있나요?
기본적으로는 모릅니다. 공식 문서에 따르면 서브에이전트는 새 컨텍스트 창에서 시작하고 대화 기록을 보지 못합니다. Claude가 일을 넘기면서 써 주는 위임 메시지를 받아 거기서부터 일합니다. 대화를 이어받는 포크 방식은 예외입니다.
서브에이전트를 쓰면 토큰이 더 드나요?
서브에이전트는 자기 요청을 따로 보내고, 그 요청은 메인 대화와 같은 사용 한도에 합산됩니다. Anthropic은 리서치 시스템 글에서 자사 데이터 기준으로 멀티 에이전트 시스템이 일반 채팅의 약 15배 토큰을 쓴다고 밝혔습니다.
글에 나온 규칙 파일과 에이전트는 Claude Code에서 쓰는 방식이고, 공식 안내는 Claude Code 공식 문서에 있습니다.
이 글은 직접 만들고 운영하며 남긴 기록입니다. 적힌 수치는 작성 시점의 제 계정 기준이며, 같은 결과나 수익을 보장하지 않습니다.
10 Comments