AI 핫토픽 – 엔비디아 RTX Spark와 PAIR(Personal AI Router), 내 PC들로 AI 에이전트를 돌리는 구성
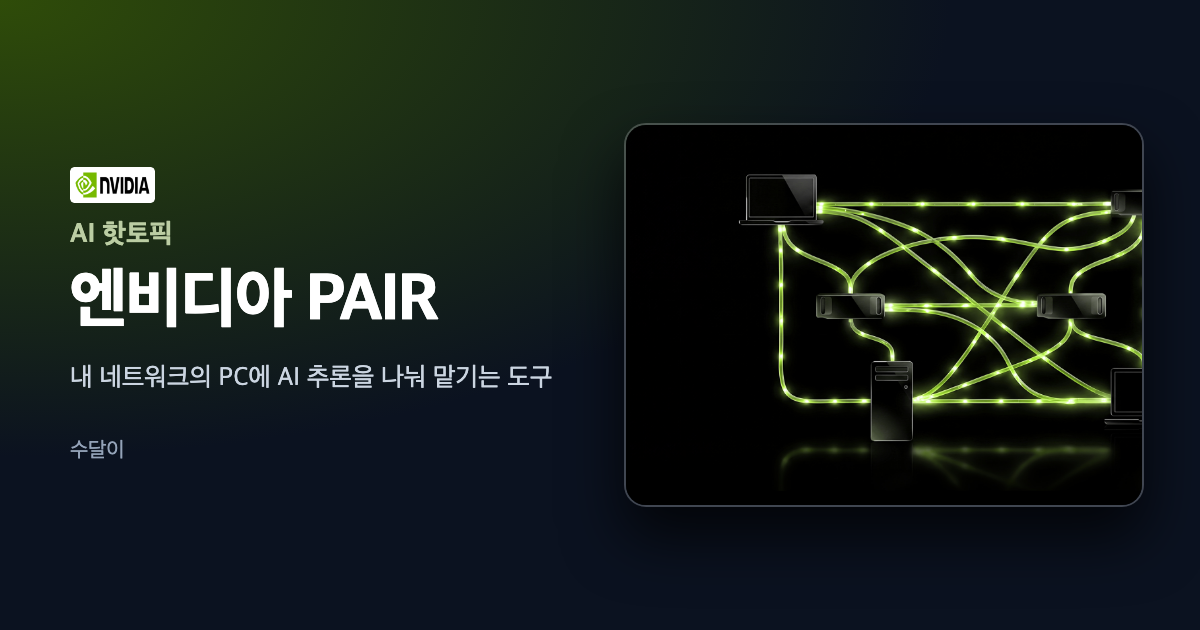
엔비디아 PAIR(NVIDIA PAIR)는 같은 네트워크에 있는 여러 대의 PC에 AI 추론(Inference)을 나눠 맡기는 무료 오픈소스 도구입니다. 엔비디아는 2026년 9월 3일 IFA 2026 발표에서 이 도구와 함께, 10월에 나오는 RTX Spark 윈도우 PC를 소개했어요. 이 글은 기준일 2026-10-08의 공식 자료만으로 정리했습니다.
PAIR의 정식 이름은 개인 AI 라우터(Personal AI Router)이고 지금은 베타 버전입니다. 엔비디아 설명으로는 윈도우(Windows), 맥OS(macOS), 리눅스(Linux)에서 그래픽 화면과 터미널 두 방식으로 쓸 수 있습니다. 이 글은 처음 보는 사람이 따라 볼 수 있도록 설치 순서와 지원 환경에 무게를 두고 적었어요.
엔비디아 PAIR가 맡는 일
로컬 에이전트(Agent)는 큰 일을 여러 작은 일로 쪼개 서브에이전트(Subagent)에게 맡기는 경우가 많습니다. 엔비디아 기술 블로그에 따르면 사용자 입장에서는 일 하나인데, 모델 호출로는 수십 건이 될 수 있고, 그 호출이 한 대의 GPU에 몰리면 줄이 길어집니다.
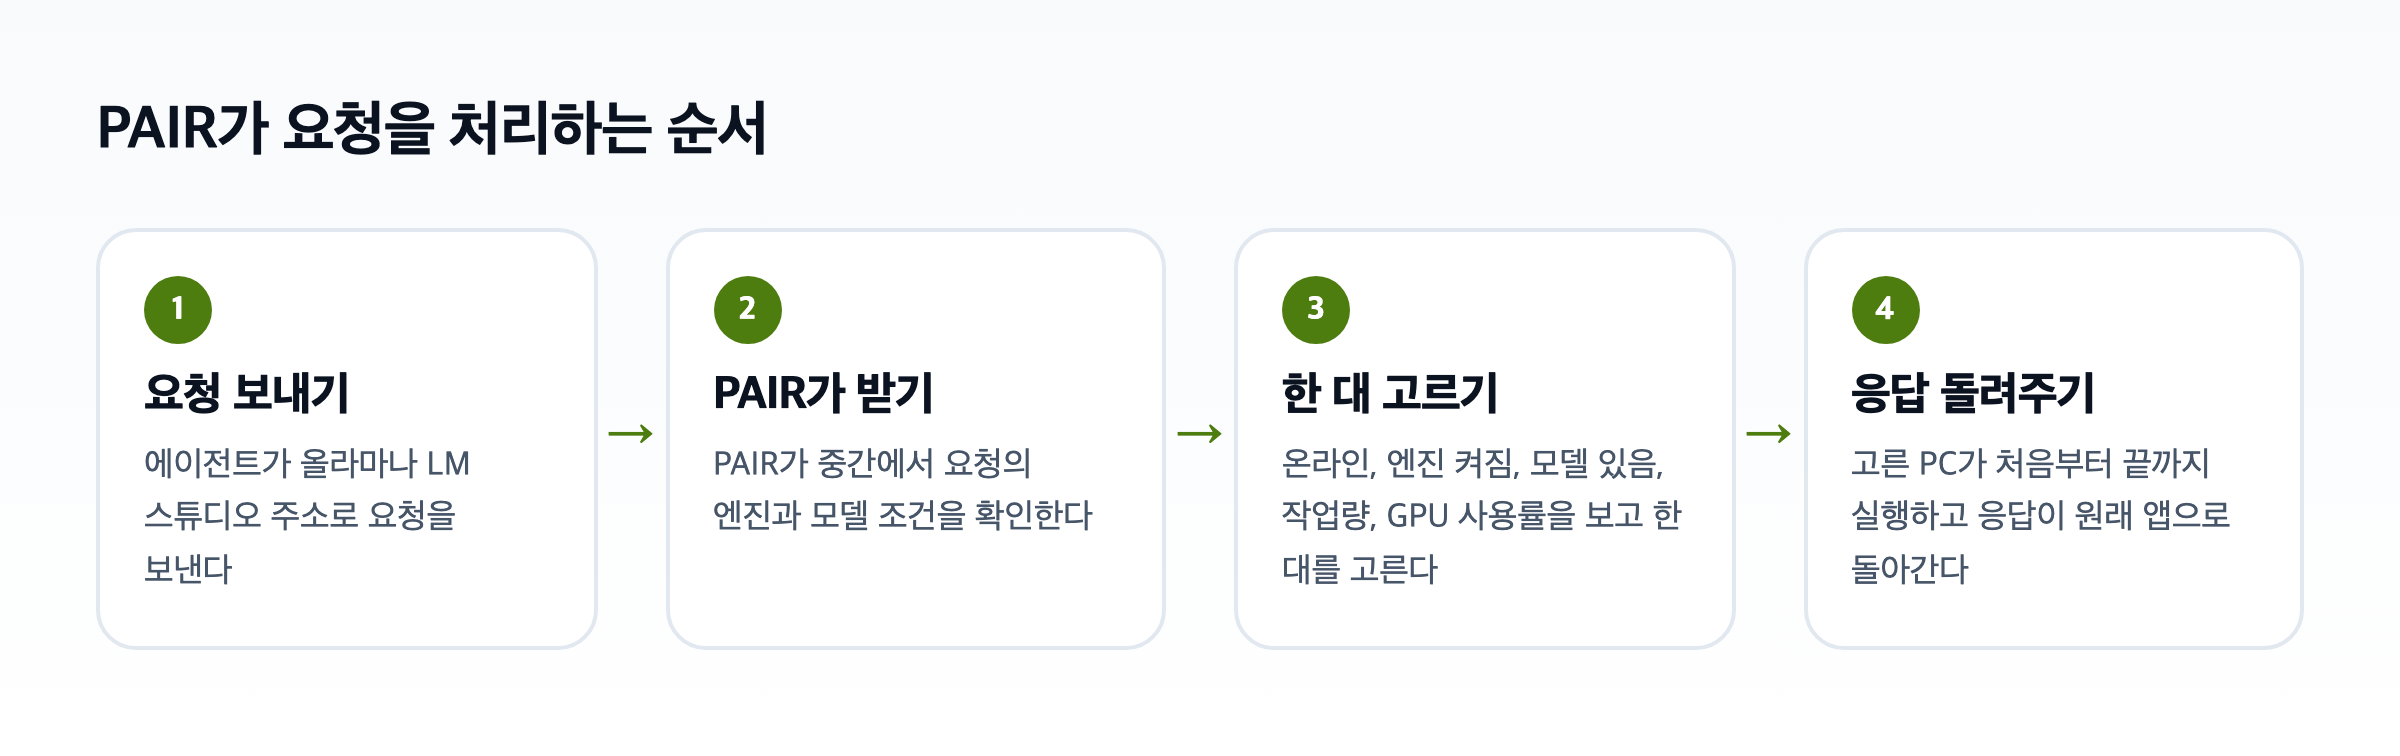
엔비디아 PAIR는 이 호출을 같은 네트워크의 다른 PC로 보내 줍니다. 엔진이 새로 생기는 것은 아니에요. 모델은 여전히 올라마(Ollama)나 LM 스튜디오(LM Studio)가 돌리고, PAIR는 어떤 PC가 준비돼 있는지 살피고 요청을 한 대에 배정한 뒤 응답을 원래 앱에 돌려줍니다. 에이전트 쪽에서는 연결이 하나로 보입니다.
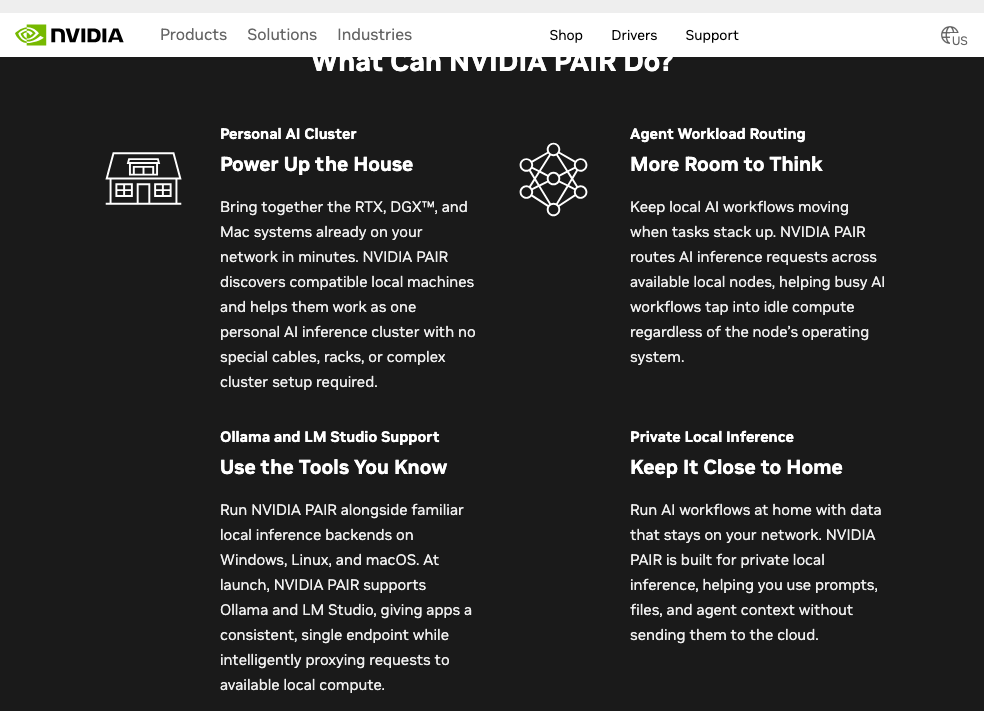
엔비디아 PAIR 제품 페이지는 네 가지 특징을 내세웁니다. 이미 집에 있는 RTX, DGX, 맥 기기를 묶어 개인 AI 클러스터로 쓴다는 것, 요청을 남는 컴퓨터로 라우팅한다는 것, 올라마와 LM 스튜디오를 그대로 쓴다는 것, 프롬프트와 파일이 네트워크 밖으로 나가지 않는다는 것입니다.
엔비디아 PAIR 설치 전에 확인할 지원 환경
엔비디아 PAIR 제품 페이지의 요구 사양은 아래와 같습니다. 윈도우 PC 기준으로는 Windows 11과 RTX 20 시리즈 이상 GPU가 있는지, 맥은 M4 이상인지가 첫 관문입니다.
| 항목 | 제품 페이지에 적힌 내용 |
|---|---|
| 운영체제 | Windows 11, DGX OS, 맥OS 테호(Tahoe), 우분투(Ubuntu) |
| GPU | GeForce RTX 20 시리즈 이상, DGX Spark/GB10, M4 이상 맥 |
| 메모리(RAM) | 8GB 이상 |
| 디스크 | 20GB 이상 권장 |
| 인터넷 | 운영에는 불필요, 모델 내려받기에는 필요 |
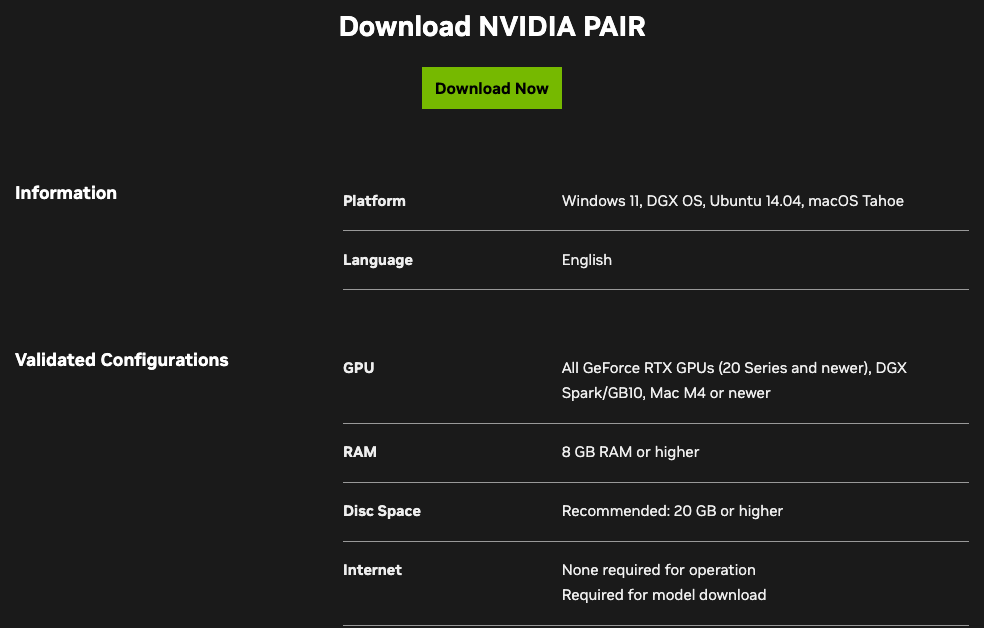
우분투 버전 표기는 직접 확인하세요
제품 페이지 표에는 우분투가 “14.04”로 적혀 있습니다. 같은 페이지의 다른 설명이나 기술 블로그에는 우분투 버전이 따로 나오지 않아, 이 숫자가 맞는지는 확인하지 못했습니다. 리눅스에서 쓰려면 내려받기 전에 최신 안내를 보세요.
기술 블로그와 IFA 발표 글은 GPU 범위를 조금 더 자세히 적습니다. GeForce RTX 20 시리즈 이상, 튜링(Turing) 아키텍처 이후의 RTX PRO 워크스테이션 GPU, DGX Spark, 애플 M4 이상 칩입니다. 내 PC의 그래픽카드가 이 범위에 드는지 먼저 확인하면 됩니다.
서브에이전트 – 역할을 나눠 검증하는 방법엔비디아 PAIR 설치부터 에이전트 실행까지
제품 페이지는 내려받기, 기기를 클러스터에 추가, 앱과 에이전트 실행의 세 단계로 소개합니다. 기술 블로그는 이를 더 풀어 적어요.
- 지원되는 윈도우, 맥, 리눅스용 엔비디아 PAIR 베타를 내려받아 묶을 기기마다 설치합니다.
- 같은 네트워크에서 기기를 찾아 보안 연결(페어링) 요청을 승인합니다. 자동 탐색(mDNS)이 기본이고, IP 주소로 직접 추가할 수도 있습니다.
- 올라마나 LM 스튜디오를 켜고, 필요한 모델을 각 기기에 내려받거나 넣어 둡니다.
- 올라마나 LM 스튜디오를 쓰는 에이전트를 PAIR가 설치된 PC에서 실행합니다.
페어링 전에는 기기 사이 통신이 모두 막혀 있고, 연결된 뒤에는 생성된 인증서로 MTLS 암호화를 한다고 기술 블로그는 설명합니다. 모델이 모든 기기에 똑같이 있을 필요는 없어요. 요청한 모델이 있는 기기만 그 요청을 받을 수 있고, 같은 모델을 더 많은 기기에 두면 선택지가 넓어집니다. PAIR가 엔진 설치와 모델 내려받기를 도울 수 있다는 설명도 있습니다.
한 가지 알아 둘 점은 포트(Port)입니다. 엔비디아 PAIR는 올라마와 LM 스튜디오가 쓰는 기본 포트를 넘겨받는 방식으로 요청을 중간에서 받습니다. 에이전트가 다른 포트를 쓴다면 PAIR의 엔진 설정에서 프록시 포트를 바꿀 수 있다고 합니다.
요청이 어디서 실행되는지 확인하는 방법
PAIR는 요청마다 기기가 온라인인지, 지원 엔진이 켜져 있는지, 요청한 모델이 정확히 있는지, 지금 작업량과 GPU 사용률이 어떤지를 보고 한 대를 고릅니다. GPU 사용률을 보는 이유로 엔비디아는 그래픽 부하가 큰 앱이나 도구가 돌고 있는지를 듭니다.
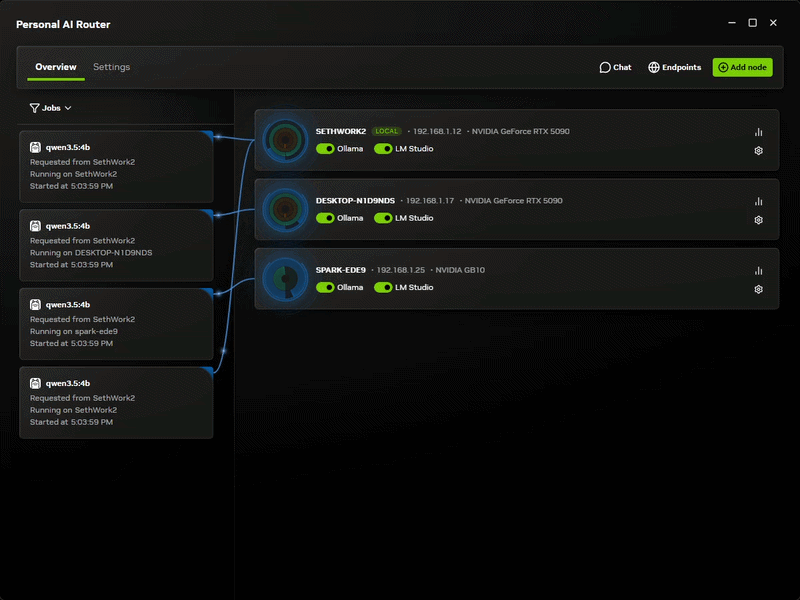
기술 블로그의 시연에서는 역할이 이렇게 나뉩니다. 허미스가 일을 쪼개고 합치고, PAIR가 어디서 실행할지 정하고, 올라마가 고른 기기에서 모델을 돌립니다.
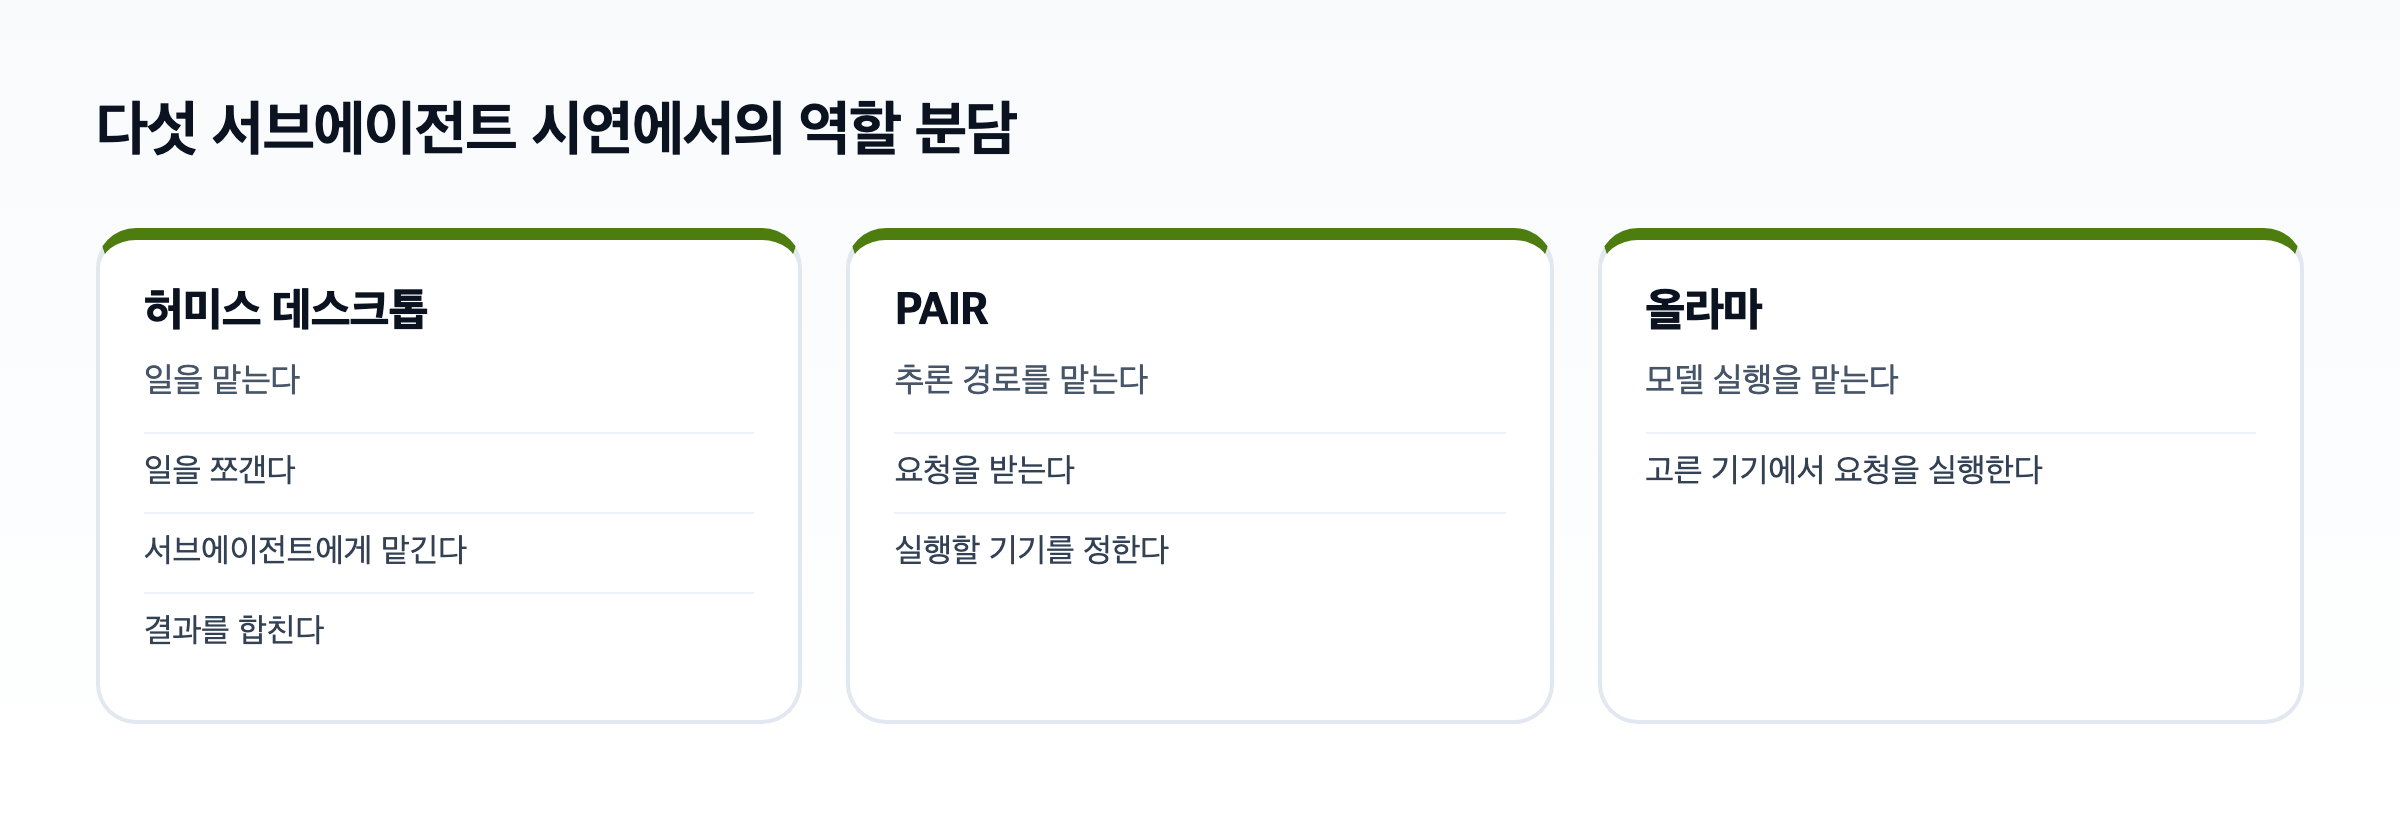
위 앱 화면은 기술 블로그에 실린 것입니다. 작업(Jobs) 보기에서 어느 기기가 어떤 요청을 처리했는지 볼 수 있고, 엔비디아는 여러 대에서 실행됐다는 주장은 이 화면에 여러 기기의 작업이 찍힐 때만 하라고 적었습니다. 에이전트 수와 PAIR의 작업 수는 서로 다른 숫자라고도 덧붙였어요.
오토 모드(Auto Mode) – 승인 대신 분류기가 검사하는 구조엔비디아 PAIR가 하지 못하는 일
기술 블로그는 엔비디아 PAIR가 하는 일과 하지 않는 일을 나눠 적습니다. 오토 모드처럼 에이전트의 권한을 다루는 방식과는 별개로, 이쪽은 계산 자원을 어떻게 나누느냐의 이야기입니다.
PAIR가 하는 것
- 독립된 요청을 준비된 PC에 나눠 보낸다
- 한 엔진 뒤에 줄 서는 요청을 줄인다
- 메인 PC를 게임이나 작업에 쓰게 비워 준다
PAIR가 하지 않는 것
- GPU를 합치거나 VRAM을 하나로 묶지 않는다
- 요청 하나를 여러 기기에 쪼개지 않는다
순서대로 이어지는 작업, 긴 모델 호출 하나가 대부분인 작업, 요청한 모델이 한 대에만 있는 구성에서는 효과가 작을 수 있다고 엔비디아는 밝힙니다. 그래서 실제로 쓰는 작업으로 완료 시간을 재 보라고 권합니다.
엔비디아가 공개한 시연이 하나 있습니다. 허미스 데스크톱(Hermes Desktop)으로 서브에이전트 다섯 개를 돌렸을 때 RTX Spark 노트북 한 대에서는 평균 18분, RTX Spark 노트북과 DGX Spark, RTX 5090으로 이뤄진 세 대 구성에서는 평균 8분 48초였습니다. 엔비디아는 이것이 특정 구성의 비공식 시연이지 일반 벤치마크(Benchmark)가 아니고, 성능이 기기 수에 비례한다는 약속도 아니라고 적었어요.
RTX Spark 윈도우 PC는 언제 나오나
RTX Spark는 엔비디아가 5월 31일자 보도자료로 소개한 윈도우 PC용 칩입니다. 10월 7일 엔비디아 블로그는 노트북 사전 주문이 열렸고 10월 16일에 구매할 수 있으며, 소형 데스크톱은 11월에 판매된다고 알렸습니다. 에이서(Acer), 에이수스(ASUS), 델(Dell), HP, 레노버(Lenovo), 마이크로소프트(Microsoft), MSI, 기가바이트(Gigabyte)에서 제품이 나옵니다. 제품 가격은 옮기지 않았으니 각 제조사 안내를 보세요.
엔비디아는 RTX Spark를 블랙웰(Blackwell) GPU와 20코어 그레이스(Grace) CPU를 묶은 칩으로 설명하고, 항상 켜 두는 에이전트를 돌릴 소형 데스크톱 구성도 함께 소개했습니다. 엔비디아 PAIR와 짝으로 보면 RTX Spark PC도 묶을 수 있는 기기 중 하나입니다. 앞의 시연에도 RTX Spark 노트북이 들어 있었어요.
로컬 에이전트 설치가 쉬워진다는 발표
IFA 발표에서 엔비디아는 에이전트를 로컬에서 쓰기 위한 설정이 단순해진다고 알렸습니다. 모델 고르기, 추론 서버 찾기, 양자화 설정 같은 일을 줄이겠다는 설명입니다.
- 허미스 에이전트(Hermes Agent): 윈도우에서 로컬 모델 설정이 한 번 클릭으로 되고, 엔비디아 GPU를 감지해 모델과 설정을 고른다고 합니다. 리눅스는 곧 지원됩니다.
- 오픈클로(OpenClaw): 윈도우 앱이 VRAM 24GB 이상인 RTX GPU에서 최적화된 로컬 모델 설정을 쉽게 해 준다고 소개됐습니다.
- 퍼플렉시티 포터블 컴퓨터(Perplexity Portable Computer): VRAM 24GB 이상 RTX GPU의 리눅스에서 쓸 수 있고 윈도우 지원은 곧 나옵니다.
엔비디아는 llama.cpp와 vLLM 최적화도 함께 알렸습니다. llama.cpp는 지포스 RTX 5090에서 처리량이 최대 1.9배(모델에 따라 1.5배에서 1.9배), vLLM은 RTX PRO 6000 블랙웰에서 1.2배, DGX Spark 두 대 구성에서 최대 1.4배라는 수치입니다.
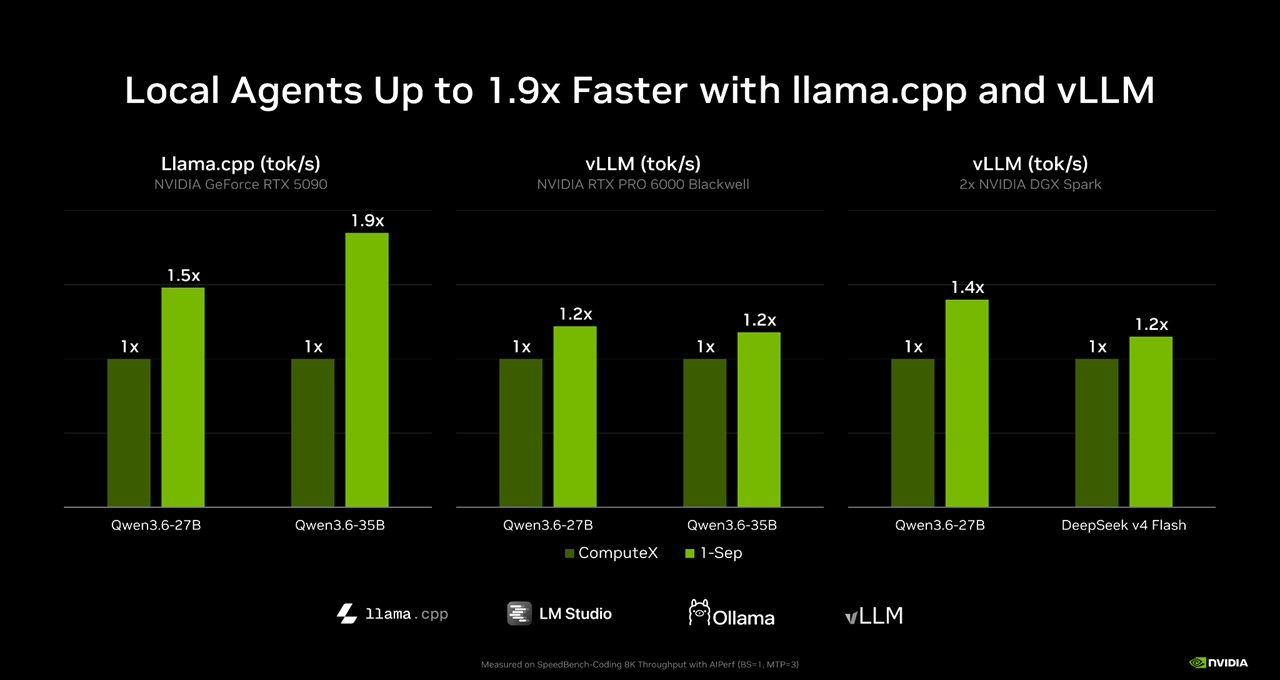
이 수치는 엔비디아가 정한 조건에서 잰 값입니다. 올라마와 LM 스튜디오로도 같은 개선을 쓸 수 있다고 하니, 엔비디아 PAIR가 앞단에 서는 환경에도 이어질 수 있습니다. 다만 두 발표가 서로 연결된다고 엔비디아가 따로 밝힌 것은 아닙니다.
참고한 공식 문서
본문은 엔비디아 블로그의 IFA 2026 발표, PAIR 제품 페이지, 엔비디아 기술 블로그의 PAIR 글, 마이크로소프트 행사 소식, RTX Spark 보도자료를 기준으로 했습니다. 베타 제품이라 지원 환경과 일정은 바뀔 수 있으니 원문을 확인하세요. 이미지는 엔비디아 공식 페이지의 화면과 그림입니다.
엔비디아 PAIR 자주 묻는 질문
엔비디아 PAIR는 유료인가요?
엔비디아는 PAIR를 무료 오픈소스 소프트웨어 도구라고 소개합니다. 현재는 베타(Beta) 버전이고 Windows, macOS, Linux용 내려받기 주소가 제품 페이지에 있습니다.
PAIR를 쓰면 GPU 여러 개가 하나처럼 합쳐지나요?
합쳐지지 않습니다. 엔비디아 기술 블로그는 PAIR가 GPU나 VRAM을 하나로 묶지 않고, 요청 하나를 여러 대에 쪼개 실행하지도 않는다고 밝힙니다. 요청마다 적합한 PC 한 대를 골라 처음부터 끝까지 맡기는 방식입니다.
PAIR를 쓰려면 PC가 어떤 사양이어야 하나요?
제품 페이지 기준으로 GeForce RTX 20 시리즈 이상 GPU, DGX Spark, M4 이상 맥(Mac)이 검증된 구성이고 메모리 8GB 이상, 디스크 20GB 이상(권장)이 적혀 있습니다. 모델을 내려받을 때는 인터넷이 필요합니다.
글에 나온 규칙 파일과 에이전트는 Claude Code에서 쓰는 방식이고, 공식 안내는 Claude Code 공식 문서에 있습니다.
이 글은 직접 만들고 운영하며 남긴 기록입니다. 적힌 수치는 작성 시점의 제 계정 기준이며, 같은 결과나 수익을 보장하지 않습니다.